HuggingArch:让模型 arch 分析自动化
花了大半年的休息时间做了这个项目。如果觉得这个项目有意思/有用,欢迎大家 star 及成为 developer,虽然我还没有想好 vibe 项目如何共建比较合理————这也是一个期望和有想法的朋友共同讨论的话题。
TL; DR
HuggingArch 让 agent 把一个开源模型自动写成一份结构描述(DSL spec),再基于这份 spec 自动做 LLM 部署分析。
- 网页:huggingarch.com
- 代码:GitHub
它应该是第一个自动做部署"算账"的框架。可以把它看成一个特殊的编译器:HuggingFace 的 config 是输入,spec 是 IR,图编译负责形状传播、并行切分和算子融合,sympy 充当 runtime——只不过它不算真实的 tensor,算的是 FLOPs、访存和显存。你只需要给一个 HuggingFace model ID,agent 生成模型结构的描述;之后的形状传播、图改写都是确定性的,一键得到这个模型在不同并行配置、不同卡型下的理论性能。于是不同 model arch 之间的比较可以做得非常轻量。
一、Intro
HuggingArch 是一个希望用 harness 的思路,让 LLM 模型推理算帐自动化的项目 ———— 只要这个模型在 HuggingFace 上开源。做这个项目的 Motivation 是很直观的,模型越来越多,作为从业者常常要分析和对比各家模型的优劣,这是模型厂和各种 MaaS 厂、芯片厂都关心的 critical issue。算账是一个劳心劳力的过程,而且门槛似乎并不低,过去一年,模型厂们大搞 hybrid,模型结构 diversity 越来越大,其实算账会变得更难算:DSA 和 KDA 哪个在长文本更省?CSA 和 HCA 相比 DSA 能更省多少?DeepSeek 这么便宜是对的吗?K3 作为 3T 级别的模型会涨多少成本?———— 光想到这些就感觉起码要算几个星期,为了脑子不OOM,2026年了我们必须让 agent 来帮我们算账了。
项目目前覆盖了model arch的计算图可视化、LLM Inference 方面的推理理论算帐,后端也直接支持了不同框架的算子性能测速(及其简单),从而快速获取真实特定部署性能。事实上,HuggingArch 还可以把各个模型的 model 模块做成可插拔的模块,然后 Model Arch Designer 可以任意地修改超参,把不同模块单元排列组成成一个新的模型,并且快速算出这个模型在不同卡型和部署方式下的成本 ——— 这也是把模型标准化为可组合的DSL表达最有趣的地方。
因为是一个纯 side project 的项目,从开始有想法到各种重构到最终觉得真的能实用才端出来,大概花了大半年的时间,一直在利用下班碎片时间和周末缝缝补补。而Model Arch在这半年时间变得越来越复杂,需要表达的语法越来越多,。在当前,利用前沿模型快速分析一个模型的kvcache和理论flops已经不是个难事,那这个项目的意义在哪里呢?简单来说 ———— 我认为是一个可信任的、可纠错的、可复用的轻量级基础设施。
可信任:纯 vibe 分析一个模型是adhoc的。agent 的分析结果需要细细溯源计算过程,才敢判断这个分析结果是不是可信。而agent反而是一个更擅长告诉你结果,而不是中间过程的思维习惯。缺乏反馈,靠agent一个turn 梭哈直接出正确结果是不现实的,模型越复杂做对的概率越小。而人工反馈是一个很低效的过程。是不是有错,出了错,错在哪里 ———— 一方面需要分析者提前熟悉这个架构才能给模型纠错,一方面这个靠反复追问 agent 只会让会话越来越长,而反复的答案令人感觉越来越不可信。
可纠错:而 HuggingArch 设计了一套 validation 系统,通过模型的原始forward代码、config 配置、模型权重等 groundtruth 信息等,能让模型自己纠错,这样低级的错误几乎都能被消灭。此外,整套系统的计算都基于 sympy 的符号系统,使得所有值的计算都源自于特定的计算公式,并且从backend 引擎直接透传到前端,让每一个公式的出错都可以被人工发现。
可复用:所有模型都会以spec的形式入库。spec 从primitive、component、model 级别抽象出三层,于是模型之间的公共组件如Attention、MoE等是可以跨模型复用的 ———— 这降低了模型生成spec的难度、减少了计算的歧义,并且控制仓库的熵增在一个比较可控的范围。当模型以模块的形式在仓库里组件搭建起来 ———— 原则上我可以在这基础上为它赋予几乎整个Graph Compiler的能力 ———— 计算图的 shape 传播、quant、激活值liveness分析、device 映射 ———— 区别只是它底层不做实际的 tensor 计算,而是做FLOPs、Memory访存的计算。于是一份简单的、agent driven 的 spec,长出了复杂的模型分析系统。
轻量级:整套分析不需要模型能运行————因此不需要算子实现,不需要框架runtime,不需要GPU。这使得任意尺寸的模型都能快速的分析出结果,并且所有结果长期可追溯。
一套 LLM 模型的推理算帐系统需要两个必备因素:
- 模型架构的表示
虽然可以手动build,但手动重建一个模型还是比较麻烦的,完全可以靠Agent来写。搭建这套系统最直接的agent需要的信息包括 ——— 模型权重形状、计算图结构及模型参数。这一切 HuggingFace 都正好有 ——— 模型权重、transformers 库以及 inference 源代码。所以我们这套 web 系统搭建基于 HuggingFace,但其实也有backend CLI 工具可以DIY(vLLM/SGlang 源代码和model weights 也是work的)。
为什么是一套 agentic 的方式来生成模型?
目标从一开始就很明确:做一个轻量、跨模型通用的分析器。权重不能下载——动辄几个 T,根本没法并发;模型也不能真跑——GPU 太贵,各种 CUDA 和推理引擎版本也太重。最直观的想法是借 transformers 的 meta device 把模型"空跑"一遍:在每层执行前 hook 一下算 FLOPs,结构用图分析拿到。结果依赖运行时的路子一条都走不通:
- meta device 只能建模型,不能跑 forward。
init_empty_weights()加from_config能拿到一个结构完整、没有权重的nn.Module,但只要真正计算就会出错——比如有的模型在 forward 里调了.cpu()。- 从 PyTorch 里抠计算图,等于把 PyTorch 编译的来路重走一遍。
torch.export处理不了依赖数据的控制流,导出的算子也碎得没法读;trace / dynamo 要构造输入,可每个模型的 forward 签名都不一样(KV cache、位置编码、top-k 索引……各传各的),很难造出合法的数据;直接分析 AST,又会卷进大量 Python 语言层面的细节。- transformers 的向后兼容太差,模型代码本身经常跑不起来。 比如 transformers 5.x 把 RoPE 配置从扁平的
rope_scaling改成了嵌套的rope_parameters,按 4.x 写的 MiMo-V2-Flash 直接报错。就算按每个模型config.json里写的版本动态切换 transformers,也会撞上别的依赖——比如 Kimi 的 modeling 代码直接 import flash_attention,在 CPU 环境里起不来。运行时这条路走不通,才有了现在的思路:不跑现有 runtime,直接用 agent 写 spec。
- inference 的算帐方法论
Speed-of-Light 估计是本项目的计算基础。LLM 的inference 由 prefill 和 decoding 两个阶段组成。每个阶段的计算 pattern,由主导其forward 时间的算子来决定。前者一般是计算密集型,因为 Gemm 算子和 Attention 算子形状都有较好的 roofline AI(算术密度),因此由GPU TFLOPS来约束其执行时间的下限,后者的 Gemm 算子和 Attention 算子一般是访存密集型,由访存带宽来约束其执行时间的下限。该指标的定义比较好的参考见 SOL-ExecBench: Speed-of-Light Benchmarking for Real-World GPU Kernels Against Hardware Limits。
根据每个算子的
1.1 核心架构
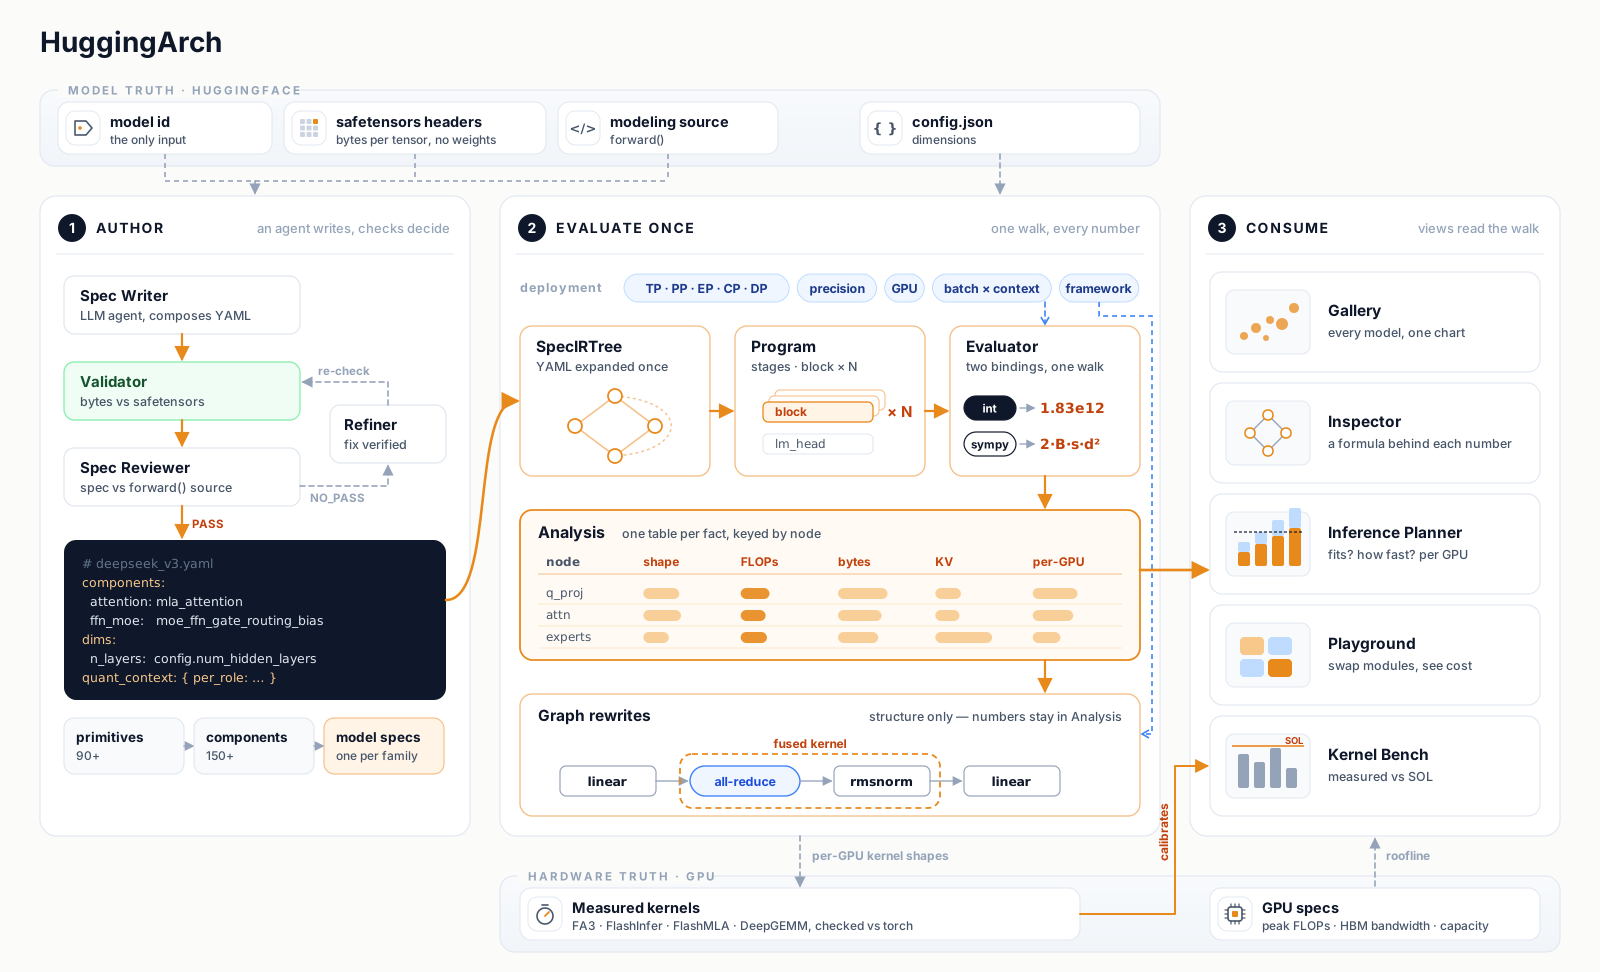
上下两层是外部事实,中间三步是系统本身:
- 模型事实:HuggingFace 上的 config、safetensors 头和 modeling 源码,是系统唯一的输入。
- ① Author:agent 写 spec,再由确定性的检查把关——字节对上 checkpoint、语义对上源码,才能入库。
- ② Evaluate once:对 spec 只求值一次,得到形状、FLOPs、显存和每卡切分;通信和融合只改图,不重算。
- ③ Consume:所有页面都读这一次求值的结果,同一个数在哪儿看都一样。
- 硬件事实:按每卡真实 shape 实测 kernel,用来校准估算。
各部分的细节分别在第二章(spec)和第三章(推理算账)展开。
二、构建 model spec
HuggingArch的核心架构设计在于一套自底向上的DAG DSL描述系统,以及基于这套DAG 的SpecTree IR————DAG是claude code 写的,SpecTree IR是built-in的框架代码,这让agent始终是在有约束的前提下发挥自己把非结构化数据转变为结构化数据的能力。始终要强调的是计算图是现在深度学习框架的核心抽象,transformers只是基于这一套抽象的特殊结构,构建好计算图理论上能表示任意的复杂模型结构。在这套IR上挂上Sympy 符号计算系统,能同时表达结构关系、形状、与运算。有了这么一个计算图的描述,在这个基础上去做更高层级任务specific的运算————比如inference kvcache容量推导、并行的推导,都只是基于spec系统的应用层。
2.1 核心:Spec 系统
HuggingArch 读 transformers 或模型官方仓库的推理源码来构建模型结构。读代码是一个开放问题,所以需要一套规范的 DSL,让 agent(如 Claude Code)知道该怎么写、写成什么样。
1) 三层 op:Primitive / Component / Model
- Primitive 是最底层的算子(
linear、rmsnorm、rope、attention_score……),由框架内置。每个 primitive 带三样东西:参数量公式、FLOPs 公式和形状规则。公式直接是 sympy 表达式,比如linear的矩阵乘就是2·B·s·in·out。 - Component 是一张由 primitive 或其他 component 组成的 DAG,写成 YAML。模型结构的多样性主要落在这一层:GQA、MLA、SwiGLU、MoE、DeepSeek-V4 的 CSA 都是 component。经过 review 的进
library/供所有模型复用;agent 新写的先放在drafts/,只对声明它的那份 spec 可见,review 通过后再并入 library。 - Model 把 component 填进 block 模板,再说明每一层用哪个模板——hybrid 模型就是不同层用不同模板。
以 DeepSeek-V3 的 MLA 为例,一份结构由三处声明拼起来(均为节选):
# components/library/mla_attention.yaml —— component:一张 DAG
role: attention                          # 能填进 block 模板的 attention 槽位
cache:                                   # decode 时跨步保留的东西
  family: MLA
  entries:
    - { node: kv_a_layernorm, kind: latent }     # 压缩后的 KV latent
    - { node: k_pe_rope,      kind: rope_key }   # 所有头共享的 rope key
decode_variant: mla_attention_absorbed   # decode 时换成在 latent 空间里算的子图
graph:
  kv_a_proj_with_mqa: { op: linear, in: x, dims: { in: d_model, out: "d_kv_lora + d_qk_rope" },
                        weight_axes: [{ replicated: true }, { replicated: true }] }
  kv_latent_slice:    { op: slice, in: kv_a_proj_with_mqa, dims: { in: "d_kv_lora + d_qk_rope", out: d_kv_lora } }
  kv_a_layernorm:     { op: rmsnorm, in: kv_latent_slice, dim: d_kv_lora }
  kv_b_proj:          { op: linear, in: kv_a_layernorm, dims: { in: d_kv_lora, out: "n_heads * (d_qk_nope + d_v_head)" },
                        weight_axes: [{ world: attention, parts: n_heads, fit: replica_cells }, { replicated: true }] }
  # … Q 的压缩与解压、拆头、rope、attention_score、softmax、attention_apply、合头
  o_proj:             { op: linear, in: o_merge_heads, dims: { in: "n_heads * d_v_head", out: d_model },
                        weight_axes: [{ replicated: true }, { world: attention, parts: n_heads, fit: replica_cells }] }
outputs: [o_proj]

# models/deepseek_v3.yaml —— model spec:往槽位里填 component,维度从 config 里取
components:
  attention: mla_attention
  ffn_moe:   moe_ffn_gate_routing_bias
  block:     pre_norm
dims:
  n_heads:   config.num_attention_heads
  d_kv_lora: config.kv_lora_rank
  d_qk_rope: config.qk_rope_head_dim

# arch/dims.yaml —— 全局维度表:每个维度只分类一次,包括哪种并行能切它
n_heads:   { kind: head_count, shardable_by: [attention] }
d_kv_lora: { kind: whole }                # latent 不分头,不可切
对应四件事:
- role 决定能插在哪。
role: attention说明它能填进 block 模板的 attention 槽位,model spec 的components:按槽位名填空。换一种注意力就是换一个 component,block 模板不动。role 统一登记在roles.yaml,没登记的名字加载时直接拒绝。 - cache 声明 decode 时留下什么。 MLA 不存每个头的 K/V,只存压缩后的 latent 和一份所有头共享的 rope key。KV cache 的公式直接从这两个节点的形状算出来:每层每 token
d_kv_lora + d_qk_rope个元素。decode_variant说明 decode 阶段换成"吸收"版本的子图,直接在 latent 空间里算注意力。 - 维度是符号,
in:是真的边。 component 里只写"n_heads * (d_qk_nope + d_v_head)"这样的表达式,具体数值由 model spec 从 config 绑定;DeepSeek-V3、Kimi-K2、LongCat-Flash 用的是同一个 component,只是维度不同。引擎顺着in:传播形状,FLOPs 和字节都从传播出来的形状算出。 - 切分分两处声明,通信不用写。 激活的每根轴能被哪种并行切,在全局维度表里只写一次(头数归 attention 的 TP,latent 维不可切)。权重的放置则用
weight_axes逐轴写在节点上:kv_b_proj的输出轴按头切,o_proj的输入轴按头切,压缩投影kv_a_proj因为 latent 不分头而整份复制;fit说明头数除不尽卡数时怎么分。集合通信不需要声明——激活的布局沿in:传播,前后对不上的地方引擎自动插入 all-reduce 之类的通信。
封装粒度不能比源码更碎。 agent 很容易把源码里一个独立的函数(比如 DeepSeek-V4 的
hc_pre)inline 展开成一堆原子算子:结构没错,但语义丢了,画出来的图也没法读。所以我们约束 spec 的封装粒度必须 ≥ 源码forward()的封装粒度——可以比源码更抽象(把多处复用的实现收成一个 component),但不能更碎。
完整的语法和设计取舍见 docs/design.md。
2) 贯穿三层的符号系统
我希望 HuggingArch 给出的不只是数字,而是可解释的公式。黑盒 planner 的假设都藏在代码细节里,而大模型 infra 的技术又一直在变;我不要求算账系统什么都能建模,但必须知道它做了哪些假设,才能判断它给的数字可信到什么程度。所以在前端 hover 任何一个值,都能看到它背后的符号表达式。
做法是让三层共用一个维度环境:primitive 的公式从里面取符号(d_model、n_heads、batch B、本步的序列长度……),component 嵌套时把绑定一层层往里传,整张图最后是一棵 sympy 表达式树。
双轨求值是这套设计最大的回报。 同一次走访,绑数值得到数,绑符号得到公式(2·B·s·d_model²)。引擎只有一份,"出数还是出公式"是绑定的属性,不是代码分支,所以公式和数字不会对不上。
异构层不打平。 hybrid 模型的总量保留成和式,比如 n_dense·MLA + (n_layers − n_dense)·MHA,算 KV cache、权重和访存时各自加总。
但符号系统只回答"数字怎么算",不证明"图本身对不对"。后者要靠下面的 checkpoint 锚点(发布前必须通过)和 forward / shape 检查(尽力而为的诊断),两者是不同强度的保证。
2.2 应对复杂的 hyperconnection:stream 机制
经典 Transformer 的层间连接只有一条:残差。第 l 层的输出就是第 l+1 层的输入,spec 只要写 repeat: n_layers,引擎按层数展开就行。这两年的模型不再满足于这一条线,越来越多的值在层与层之间"跳着走":
- DeepSeek-V4 的 Hyper-Connections:残差从一份变成
n_hidden_copies份并行副本,每层在 attention / FFN 前后做一次可学习的 n→1→n 混合; - Qwen3-VL 的 DeepStack:视觉编码器第 8/16/24 层的中间 hidden 各经过一个 merger,再分别加到语言模型第 0/1/2 层输出的视觉 token 位置上;
- Kimi-K3 的 AttnRes:每隔
Kar层取一次层入口的 hidden 攒成历史,后面每一层都对全部历史做一次注意力式的加权合并,而不是只加上一层的残差; - GLM-5 的 DSA 索引共享:full 层算出的 top-k 选择,通过
prev_topk_indices一路传给后面的 shared 层复用; - YOCO(You Only Cache Once)/ CLA(Cross-Layer Attention,跨层注意力):后面的层直接读前面某一层的 KV cache,不再自己算;
- Llava / EAGLE-3:取若干层的 hidden 拼起来,交给投影层或投机解码头。
如果每遇到一种就给 spec 加一个专用字段,DSL 会越长越乱,agent 也记不住哪种场景该用哪个字段。回头看这些结构,它们其实是同一件事:一个值在某些层迭代中产生,在另一些层迭代中被消费。 所以 HuggingArch 只保留一个概念来描述所有跨层数据流——stream。
1) 所有跨层的值都是 stream,声明在层栈上
最常见的残差本身也是一条 stream,没有任何隐式的默认通道。重复的层栈显式声明它逐层传递的主干:
- name: layers
  repeat: n_layers
  inputs: [embed_tokens]
  streams:
    hidden: { carries: true }   # 逐层传递的主干;每层出口自动收拢 TP 切分,不用另外声明
DeepSeek-V4 的 Hyper-Connections 不需要新机制:hidden 的形状就是 [B, s_ctx, n_hidden_copies, d_model],入口 hc_expand 把 embedding 复制成 n 份,每个 block 内部由 hc_pre / hc_post 两个 component 完成 n→1→n 的混合,出口 hc_head 再收回一份。"多副本残差"只是主干 stream 的形状不同,不是一种新的连接。
其余的跨层值按"谁产生、谁读"分成两类。
内部 stream:层内某个节点产生,后面层内某个节点读。 GLM-5 的 DSA 索引共享就是这样:栈上声明 stream 名,full 层的 attention component 用 stream_out 发布 top-k 选择,shared 层的 attention component 用 reads 读取:
# models/glm_moe_dsa.yaml —— 层栈上声明 stream
streams:
  hidden: { carries: true }
  dsa_topk:
    shape: [B, s_query, n_topk_keys]
    src: "GlmMoeDsaAttention.forward threads `prev_topk_indices` across layers"

# components/library/mla_dsa_attention.yaml —— full 层:把算出的 top-k 发布到 stream
stream_out: { dsa_topk: dsa_topk_mask }

# components/library/mla_dsa_attention_shared.yaml —— shared 层:读 stream,不再自己算
reads: [dsa_topk]
stream 上的 src 是这条跨层通道在源码里的出处:一句说明,加上用反引号括起来的真实代码片段(这里是 prev_topk_indices)。校验时会拿它去这个模型的 forward() 源码里查找,查不到就报错、不能发布——spec 声称的每一条跨层通道,都要在源码里找得到依据。
YOCO / CLA 是同一种写法:写方把自己 cache 住的 KV 节点 stream_out 出去,读方 reads 它。引擎沿着 stream 找到唯一的生产者,读方的访存按 cache 自己的增长规律和 dtype 计进 kv_reads,cache 只存一份。
追加 stream:在选定的迭代上把一个值"存档",攒成一个序列交给别人读。 声明时指明从哪取(from)、在哪些迭代取(after 在层出口取、before 在层入口取),读方再决定怎么读:
| 读法 | 含义 | 例子 |
|---|---|---|
read: each | 第 j 个读者读第 j 个元素 | Qwen3-VL DeepStack |
read: all | 每一层读到它之前攒下的全部历史 | Kimi-K3 AttnRes |
read: concat | 沿某个轴拼成一个张量整体读 | Llava 多层特征、EAGLE-3 辅助 hidden |
Qwen3-VL 的 DeepStack 连着用了两次追加 stream:视觉栈在第 8/16/24 层之后存下 hidden,merger 栈逐个读入;merger 的输出再攒成 deepstack_feat,语言模型的前三层逐个读取:
- name: visual.blocks
  repeat: n_vis_layers
  streams:
    hidden: { carries: true }
    deepstack: { from: hidden, after: config.vision_config.deepstack_visual_indexes, index: block,
                 src: "if layer_num in self.deepstack_visual_indexes:" }
- name: visual.deepstack_merger_list
  repeat: n_deepstack                    # 必须等于 deepstack 的元素个数
  inputs: [deepstack]                    # 第 j 次迭代绑定第 j 个元素
  streams:
    deepstack_feat: { from: out, after: every, index: block,
                      src: "deepstack_feature_lists.append(deepstack_feature)" }
- name: language_model.layers
  repeat: n_layers
  streams:
    hidden: { carries: true }
    deepstack_feat: { read: each }       # 前 n_deepstack 层的注入节点逐个读取
Kimi-K3 的 AttnRes 则是 before + read: all:
streams:
  hidden: { carries: true }
  block_residual:
    from: hidden
    before: { every: Kar }               # 第 0、Kar、2·Kar … 层的入口
    read: all                            # 每层读到它之前攒下的全部历史
    src: "block_residual = torch.cat("
read: all 让不同层看到的历史长度不同(第 l 层看到 ⌈l/Kar⌉ 条),形状和 FLOPs 也就不同。引擎按"可见历史长度"把同一个声明拆成若干组分别求值,展示时再按声明合并回一张卡片,并给出"历史长度 → 层号"的分布。计算是精确的,页面仍然是 3、4 种层,而不是一千多行。
2) 为什么这样设计
- 一个概念覆盖全部场景。 上面六种结构,没有一种需要专用字段。新模型再出现一种跨层连接,大概率也只是"从哪取、在哪取、怎么读"的一个新组合。
- 声明位置统一。 stream 只在层栈上声明;需要在组件内部某个节点读写的,由组件的
reads/stream_out绑定。看一个模型的跨层结构,只需要读它的model:部分。 - 每条 stream 都带源码锚点。
src:引用 forward 源码里产生或消费这个值的那一行,和其它 source anchor 一样由 validate 核对,所以 spec 里不会凭空多出一条源码里不存在的数据流。 - 约束交给 schema。 写错的 stream 在加载或 validate 时直接报错,报错里给出正确写法,作为可修复的错误交回生成 agent。比如想用
slice从层栈里"取第 i 层的输出",它其实只能读到最后一层,这种写法会被拒绝,并提示改用after: [i]的追加 stream。生成提示词里只放一张"forward 写法 → stream 写法"的正面对照表,不列反面清单。
2.3 事实来源:Ground Truth 从哪来
为了让 spec 生成既精准又便宜,HuggingArch 从 HF 模型的多个事实源拉取信息,完全不下载权重:
config.json:通过backend/analyzer.py的_fetch_config(),依次尝试本地 custom-model 缓存、内置 snapshot(backend/arch/snapshots/)、HF Hub 在线下载。这是模型尺寸(d_model/n_layers/n_heads/d_ffn/n_vocab等)的标量来源。- 模型骨架打印:
_fetch_model_str()利用init_empty_weights()在 meta device 上构建一个空模型,然后print(model)拿到模块层级树。这一步不下载权重、不跑 forward——只为了拿到嵌套的nn.Module名称结构和 shape 注解。结果会被缓存在~/.cache/huggingarch/model_info/。 - forward 源码:
backend/hf/forward_source.py依次尝试 snapshot、custom model、本地 transformers 的inspect.getsource()、model-info cache 和 HF repo 源文件,把可得的实现交给 spec 生成 agent,也供 best-effort AST 结构诊断使用。 - safetensors 索引:
backend/hf/metadata.py(一个相当大的模块)只用 2–3 个 HTTP range 请求拉到model.safetensors.index.json和每个 shard 的 metadata block,得到每个 tensor 的名字、shape、dtype、storage bytes——但不会下载任何权重字节。这是参数量 + bytes 校验的 ground truth。
对于不在 transformers 主干、只在 model card 中以 trust_remote_code 形式给出的私有仓库(典型如 Kimi、MiMo、GLM-MoE 等),HuggingArch 走 HF Hub 拉模型 repo 里的 modeling_*.py 与 configuration_*.py,将 forward 源码输入给 agent;遇到 flash_attn 这类 native 依赖时也不会真的去 import,只是当作文本来读——由此规避了"runtime 无法运行"的困境。
这些输入进入两条不同强度的路径:forward 源码与模型骨架辅助生成并产生非 gating 结构诊断,safetensors metadata 则进入总字节和 tensor coverage gate。
2.4 Shape inference:spec 内部的几何一致性
让 agent 写 spec 时,最容易踩的不是参数量错 —— 那种错容易被后面讲的 tensor 比对兜住。最容易踩的是几何错:MLA 的 k_pe 忘了 broadcast 到所有 head 就直接 concat、view_split 在一个本来不是 n_heads·d_head 的 flat dim 上做、Q 和 K 的 head_dim 对不齐 …… 这些错在参数量上完全可能正好抵消(一个 linear 多算几个参数、另一个 linear 少算几个,bytes diff 还是 0),但 forward 数据流是错的。spec 看似通过校验,跑 inference analyzer 却给出离谱的 KV cache、错误的 attention type、互相不对齐的 shape badge。
这个问题的根本难点是:HuggingArch 不跑模型,怎么验证 forward 拓扑是对的?
最初的版本走过一段弯路:试图让每个 component 自己声明每个节点的 shape:,引擎只查一致性。但这条路本质是把负担推给 spec 作者 —— 一个有 60 个节点的 V4-Pro block,作者要把每个节点的 shape 算清楚写进 yaml,错的概率比直接写 forward 还高。
最终的路径是把 shape inference 做成 first-class 机制:
in:不是注释,是真正的 dataflow edge。引擎顺着每个节点的in:以 UID 查询Analysis.shapes中的上游输出,交给当前 op 的 DimMap。- 每个 primitive 声明一个
shape_kind,内置 op 目前使用 9 种(preserve/broadcast/axis_replace/axis_select/axis_concat/contract/permute/source/explicit),引擎编成 DimMap 做形状推断。YAMLcustom_ops可声明前 7 种;需要 DimMap 的source/explicit必须注册为 built-in op。 - 多尺度统一:component 内的节点之间、component 嵌套调用、跨 model 层(每一层的
shape_out作为下一层inputs[0]的输入)—— 三个尺度共用同一套 dataflow 传播。V4 那种[B, s_ctx, n_hidden_copies, d_model]的 hyper-connection 输入走过整张图,引擎看到的就是真实张量形态,不需要下游反向猜。
把 shape 抬到 first-class 之后才有了关键能力:validate 阶段可以在不跑数值的前提下做几何一致性检查。axis_concat、attention_score、contract 以及部分多输入 add / mul 等受支持的规则会检查 rank、非 axis 维和 Q/K head_dim 等关系。结果写入 shape_mismatches,并且进入 errors:张量拼不起来的图,不能因为 checkpoint 字节总数碰巧相等就发布。
这条路径的真正价值是让 spec 自己声明的数据流可以被一致地传播和检查。它能发现内部几何矛盾,但自洽的错误图仍可能通过,因此不能称为 forward 源码的本地复现。
2.5 Tensor weights:参数量与量化的 ground truth
LLM 写出"看起来很合理但其实哪里错了"的 spec 是日常。但只要权重还在 ckpt 里,真相就在那里 —— safetensors 不会撒谎,它的 tensor 名字和字节数是上游模型团队亲手放进去的事实。问题是怎么把这份事实拿来当校验。
一份事实,两层信息
HuggingFace 的 tensor 命名遵循一套相当稳定的公约:
model.layers.X.self_attn.q_proj.weight                         ← 标准 LLM
model.layers.X.mlp.experts.X.gate_proj.weight                  ← MoE
model.vision_tower.encoder.blocks.X.attn.q_proj.weight         ← vision tower
model.language_model.layers.X.self_attn.q_proj.weight ← 多模态嵌套这套命名同时编码了两类信息,校验机制分两路处理这两类信息。
拓扑信息(哪一层、哪个 attention slot、哪个 expert)—— 由命名前缀的层级表达。validator 用 canonical_module_path() 同时归一化 HF tensor 与 spec leaf,再做 canonical key 的相等连接;不存在独立的 HF normalizer 或最长后缀兜底。异构 stack 里多个 spec leaf 可以归到同一个 canonical module path,matcher 会把它们聚合后再与 HF module 对账。
量化打包信息(这是 GPTQ qweight 还是 MXFP4 _blocks 还是 FP8 .weight + scale_inv)—— 由命名后缀和 dtype 共同表达。这部分 HuggingArch 的策略是把每种 quant scheme 的 on-disk 表示写成 yaml:主权重的 packing 因子 / 存储 dtype / 后缀,元数据 sibling 的 suffix 与 cardinality 公式,逻辑 element format 的判定规则,scale granularity 类型。
这句话听起来平淡,但它是一个有意识的边界划分:tensor 命名公约和打包细节这种"上游 transformers / autoawq / compressed-tensors / 各家训练框架各有各的写法"的散乱知识,本来散落在多个 Python 库里,每加一个新 scheme 就要进一处侵入式逻辑;归一进 yaml 之后,新增 quant scheme 是声明 yaml 的活,不是改 Python 的活。下游所有消费方共享同一份事实源。
量化的解耦:架构 vs 存储
模型架构和量化方式是两件可以独立组合的事:同一个 DeepSeek-V3 有 BF16、FP8、INT4 各种 checkpoint;同一份 checkpoint 也可以问"换成 FP4 部署会怎样"。所以 spec 把两者分开写:
- 架构与 dtype 无关。
linear只关心参数量和 FLOPs,公式里没有 dtype。 - 存储单独声明。 spec 带一段
quant_context,按 role 声明量化方案,少数例外再用 override 单独点名。比如 gpt-oss 只量化 MoE、其余保持 BF16:
quant_context:
  per_role:
    ffn_moe: { method: mxfp4, group_size: 32 }
    default: { method: none }
  default_dtype: BF16
权重字节只在一处由几何和格式合起来算出,校验、容量、KV、前端徽章都读这一份,不再各自去解析 HF 的 quantization_config。量化一旦在多处各算各的,混精模型马上就会对不上。
于是 spec 能同时回答两个问题:它实际是什么(拿 quant_context 和真实 checkpoint 对账),以及换个精度部署会怎样(用一份精度档改写权重、激活、矩阵乘、缓存的格式,没改到的保持出厂精度)。换精度只是换一份绑定重新求值,不需要第二套计算。
硬判据:逐张量对字节
最终的硬判据是字节:spec 算出每个权重在磁盘上占多少字节,和 safetensors 头里逐张量记录的字节数对账。用字节而不用元素个数,是因为混精 checkpoint 里(FP4 专家 + FP8 attention + BF16 norm)只有物理字节不需要换算单位。没被任何 spec 节点认领的张量、元素数对不上的张量,都直接算 error;总字节数相等只是最后一道校验和——它能抓住宽度写错,但看不出两个子模块互换了位置。
2.6 Guard:错了,有没有东西接得住
先讲一次真实的翻车。DeepSeek 发布 V4-Pro 之后,我让一个 agent 写了一篇 V3 / V3.2 / V4-Pro 在 8×B200 上的部署算账:prefill、decode、max-batch,上下文从 4K 扫到 1M。它写得有模有样——架构差异梳理得很细,定性结论也站得住,通篇 roofline 公式和 sweep 表。拿 HuggingArch 一对账:定性全对,定量翻车。
- V3 在 1M 上下文的 prefill,文档写的是 73.48 µs/token,按第一性原理重算约 150——漏乘了一个 ×2。单看那一格完全看不出来,可它是基线,一错就污染整列:V4 相对 V3 的 prefill 加速被写成 4.7×,真值是 9.4×,这个模型最该讲的卖点被说小了一半。
- 短上下文更隐蔽:文档默认 prefill 受算力约束,但单请求的短上下文 prefill 其实受权重搬运约束——一大堆 MoE 专家的权重要从 HBM 读上来。这不是抄错数,是建模假设在某个区间悄悄失效了。
agent 写的东西看起来比人写的还专业,但里面藏着的 ×2 和失效的假设,它自己发现不了;再让 agent review 一遍也兜不住——幻觉 review 幻觉,只会越看越觉得对。所以 HuggingArch 的出发点不是不让 agent 算账,而是不让它在没有约束的真空里算:agent 写的是一份受约束的 spec,每一步都有外部事实能接住它。
这些"接住它的东西"就是 guard。它们按强度分两种:会挡住发布的,和只给反馈的。
| Guard | 对照什么 | 挡住哪类错 |
|---|---|---|
weight | safetensors 头里每个张量的名字、形状和字节 | 有张量没被 spec 认领;元素数或字节对不上;总字节、文件实际字节不等 |
packing | 量化打包方式 | 存储元素数和 dtype 各自对不上(两个错误互相抵消、总字节碰巧相等);量化 override 没命中任何张量 |
shape | spec 自己的维度和算子规则 | 张量拼不起来 |
analysis | 求值本身 | spec 走不完一次求值 |
schedule | config.json 里的逐层列表和参数取值 | 逐层安排没覆盖列表里出现的每种取值;config 指定的参数没绑到对应算子上 |
structural | config 里的 RoPE 分段、各注意力的 mask | 旋转位置编码的分段、因果 / 双向 mask 与 config 不符;有参数声明了却没被用到 |
axiom | 组件作者写下的逐层不变量(KV 怎么增长、滑窗多大)、缓存声明 | 求值结果和声明对不上;config 声明了滑窗、spec 却没有一条封顶的缓存;缓存的读写规律自相矛盾 |
source | forward() 源码 | 跨层 stream 的源码锚点在源码里找不到,或没有生产者 / 读者 |
上面每一行都会挡住发布。另有一批检查只给 agent 反馈、不挡发布:拿 AST 对照 forward() 的调用顺序和残差个数、逐模块试跑、激活函数与 config 是否一致、参数量与 model card 是否一致、draft 之间有没有重复。
能不能发布只看一件事:validate() 返回的 errors 是否为空。也要说清楚两点边界。其一,这些检查各管一类错,合起来也不能证明 spec 和 forward 完全等价——shape 只说明张量拼得起来,AST 对照只比调用顺序和残差个数,语义层面的对齐要靠 2.8 节的审查。其二,schema 只挡写错的引用和没登记的 role,不挡新拓扑:遇到 library 里没有的结构,agent 直接在自己的 spec 里 inline 一个新 block 就行,新拓扑的成本应该是"写一份新 YAML",而不是"先改 library"。
guard 真有必要吗? 我们做了一个受控实验(完整报告见 docs/guard_ablation/report.md):让 agent(Claude Opus 4.8)在去污染的沙盒里从零重写三个模型的 spec——目标自己的 component、全库同类 component、别的 spec 全部拿掉,只留通用积木和目标的源码、config、张量名——再把 guard 从全关逐档装回,每档跑 3 个 seed。
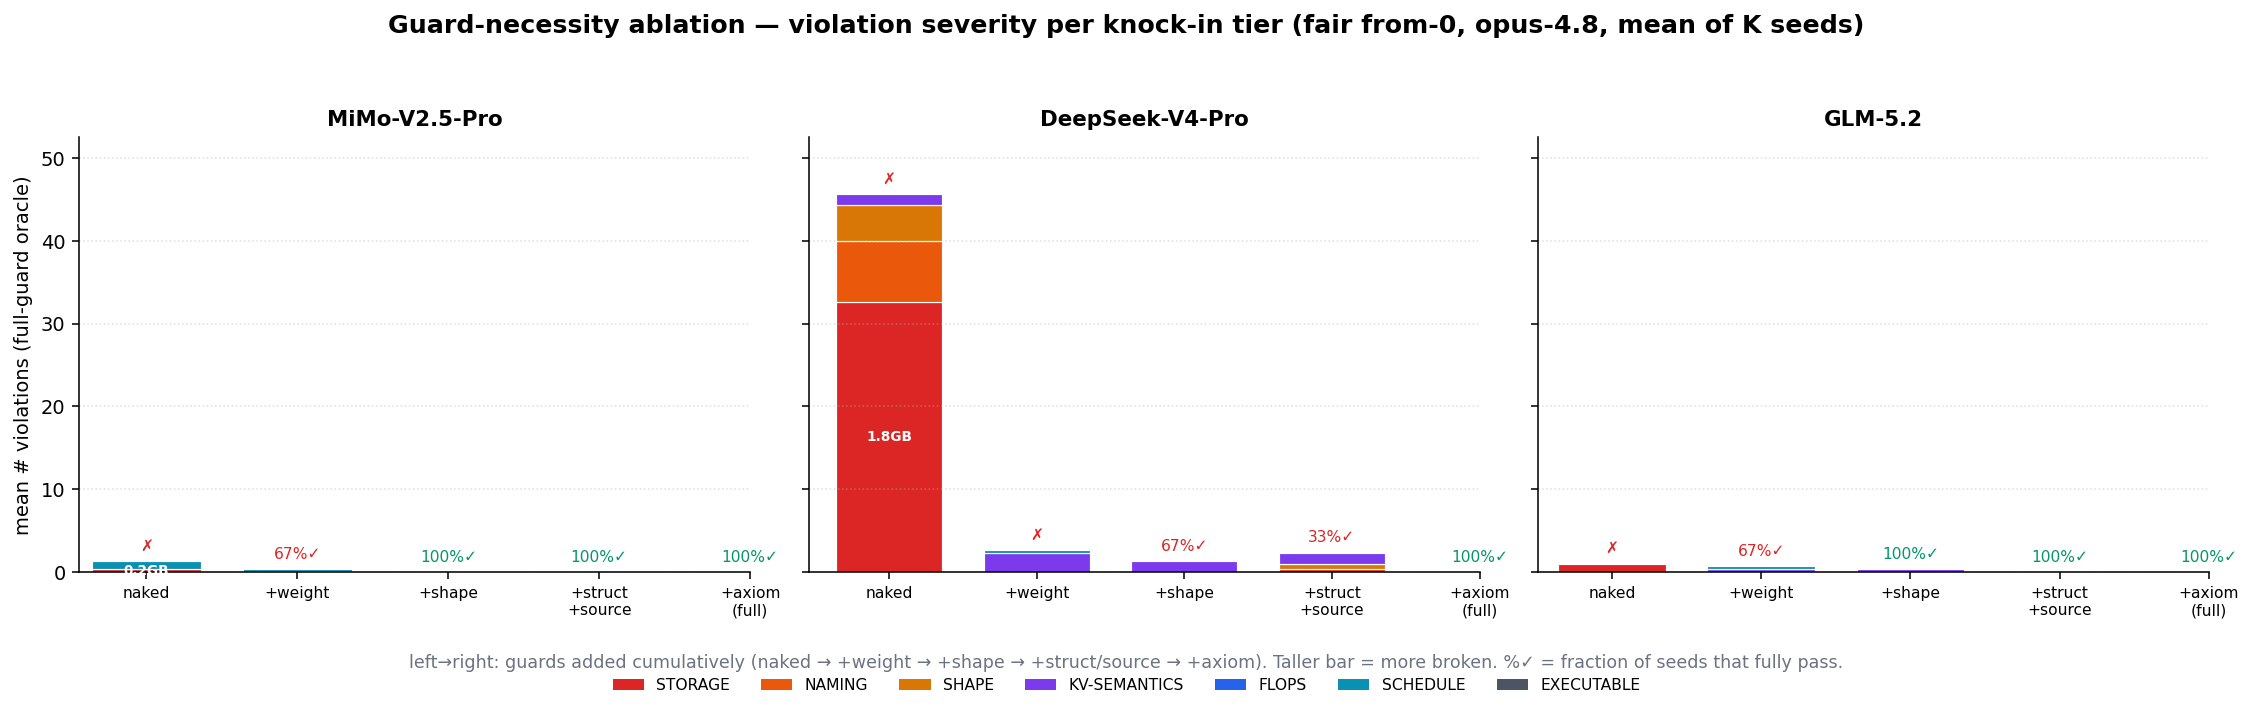
| 模型 | 全关(无 guard) | 全开 |
|---|---|---|
| DeepSeek-V4-Pro(1T,Hyper-Connections) | 0% 通过:平均 32.7 处存储错误,字节差 1.8 GB | 100% 通过 |
| GLM-5.2(MLA + DSA + MoE) | 0% 通过:存储错误 | 100% 通过 |
| MiMo-V2.5-Pro(滑窗 + 合并 QKV) | 0% 通过:存储与逐层调度错误 | 100% 通过 |
每装回一道 guard,就消掉它对应的那类错误。最值得注意的是失败的样子:在全关和只开 weight 的档位,agent 退出时报告成功,它自己那套被削弱的校验也是绿的——它以为自己写完了,可全开的校验一测,spec 是坏的。另一组对 8 个不同 coding agent 的实验里,全关时有 94% 的错误 spec 被 agent 自判为"通过",guard 全部装回后降到 6%。越难推导的模型越需要 guard:V4-Pro 从零推导一次要 62–87 轮、44–63 分钟、14–22 美元,是另两个模型的 3–4 倍,错得也最离谱。(这组实验跑在较早的版本上;当前实现又给滑窗加了一道重叠的检查,"每道 guard 各自唯一捕获一类错误"的说法,要等实验迁移重跑后再确认。)
所以 HuggingArch 想解决的,从来不只是"省得每个新模型手动建一遍"的体力问题,更是"agent 算出来的账到底可不可信"的信任问题。让模型生成一篇分析太容易了,难的是让它生成可信的分析:把公式和假设摊开,把能验证的部分钉到外部事实上,把其余部分明确交给诊断和审查——这样的系统,才有资格讨论一句"V4 比 V3 快 9.4×"能不能放心发出去。
2.7 新模型 spec 的生成流程
回到最初的目标——"输入一个 HF model ID,输出一份 verified spec"。backend/spec_worker/ 把它编排成一条 agentic 流水线。绝大多数新模型在拓扑上是已有 component 的组合(一个 hybrid GQA + MLA、SwiGLU + 256-expert MoE、加 sliding window、换个 RoPE),agent 只需在 model spec 里把 attention / ffn / norm 等角色 slot 填上现成 component;已有 adapters/ shim 可以承载纯 binding 与 checkpoint naming 差异。确有新颖拓扑(如 DSv4 的 hyper-connection、CSA 的稀疏 indexer、SSM)时,agent 在 components/drafts/ 写新 component,并在 model spec 的 drafts: 中显式列出。review 通过后,maintainer 可运行 python -m backend.arch.promote <name> 以 git mv 并入 library;未 review 的 draft 只对声明它的 spec 可见,不污染全局 manifest。
流水线自动为 agent 组装 prompt:op registry、component manifest、schema 与已验证示例,以及本模型可取得的 forward 源码、config.json、safetensors tensor 清单。随后启动一个 agent 后端(claude / codex / kimi,抽象在 backend/agents/base.py),由 prompt 要求它在 sandbox 内写 YAML、运行 python -m backend.arch.validate 并按反馈迭代,直到 valid: true 或 prompt 的迭代上限。worker 本身不会把 agent 的 clean exit 当作已验证;发布缓存前会重新调用 validate(),只接受空 errors。
2.8 validate 之外:语义审查、证据核查与 Agent Fix
上面那套 guard 核对的是 spec 和外部锚点对不对得上:tensor 的名字、形状、字节,config 里的逐层列表,滑窗配置。它们很强,但有一类错误天然看不见——没有权重、不改形状、成本占比很小的运算。Gated DeltaNet 在 delta rule 之前对 q/k 做的 L2 归一化就是典型:spec 里少了这一步,参数量、存储字节、形状推导全部照样对得上,guard 一个都不会响。能抓住它的只有一件事:拿 spec 对着 forward 源码逐步读。
所以 spec 在 valid 之后还有第二段流水线。
1) 语义审查(review)。 一个审查 agent 读 spec、staged forward 源码、config.json 和 checkpoint tensor 清单,写一份报告:一张"forward 每一步 ↔ spec 哪个节点 ↔ 是否一致"的对照表,一份缺陷清单,最后给 PASS 或 NO_PASS。它回答的是 validate 回答不了的问题:spec 算的是不是源码算的那件事。
2) 证据核查。 但审查本身也是 LLM 的阅读,会出错,而且错得很自信。实际遇到过的:
- 把模型卡上写的"窗口 1024"当事实,而
config.json里是 128; - 说 MTP 有 5 层,checkpoint 里只存了 3 层;
- 两份审查对同一个库组件——就是上面那个 q/k L2 归一化——一份判缺陷、一份判可以接受。
这些错如果原样交给修复 agent,就会被"修"进 spec。因此审查报告里的每条结论都必须附上可以被程序核对的证据:
`src: modeling_x.py:120-122 "self.scaling = self.head_dim**-0.5"`   源码引用:这几行里真有这句
`cfg: text_config.sliding_window = 128`                              config 值
`ckpt: model.layers.X.mlp.gate_proj.weight = [2048, 6144]`           tensor 形状
`count: model.mtp.layers = 3`                                        checkpoint 里的层数
报告写完、结论入库之前,程序拿本次运行自己的 config、tensor 索引和 staged 源码逐条核对,把每条结论分成三类:verified(证据全部属实,且结论里的每个数字都有属实的证据背书)、unverified(没有矛盾,但证据不够)、contradicted(有证据和事实对不上)。PASS 只有在对照表每一行都 verified、缺陷清单为空时才会被记录;否则记为 error——不是说 spec 错了,而是这份审查不可信。
3) Agent Fix。 NO_PASS 的记录可以交给修复 agent。它的工单只来自三处:verified 的缺陷、本次重新跑出来的 validate 错误、加载时的可修复拒绝。unverified 的结论只给标题和"去哪核对",不给原文里的修法;contradicted 的只告诉它"这条证据和事实不符"。修完的 spec 在写回前重新走一遍加载和 validate,没过就进重试,不会把一份仍然坏的 spec 存进去。
这三层之间只有一条原则:任何拒绝都要能回到 agent 手里被修掉。 schema 拒绝写错的语法、validate 拒绝对不上锚点的 spec、证据核查拒绝不可信的结论——每一种拒绝都以结构化的错误交回给生成或修复 agent,并说明该怎么改,而不是让它直接退出。约束放在 schema 和检查器里,提示词只讲怎么写对;写错了,报错会告诉它。
2.9 spec 的可视化:Inspector
spec 可信之后,最直接的用处是把一个模型看清楚。Inspector 就是干这个的。下面以 DeepSeek-V3 为例,打开一个模型主要看三样东西。
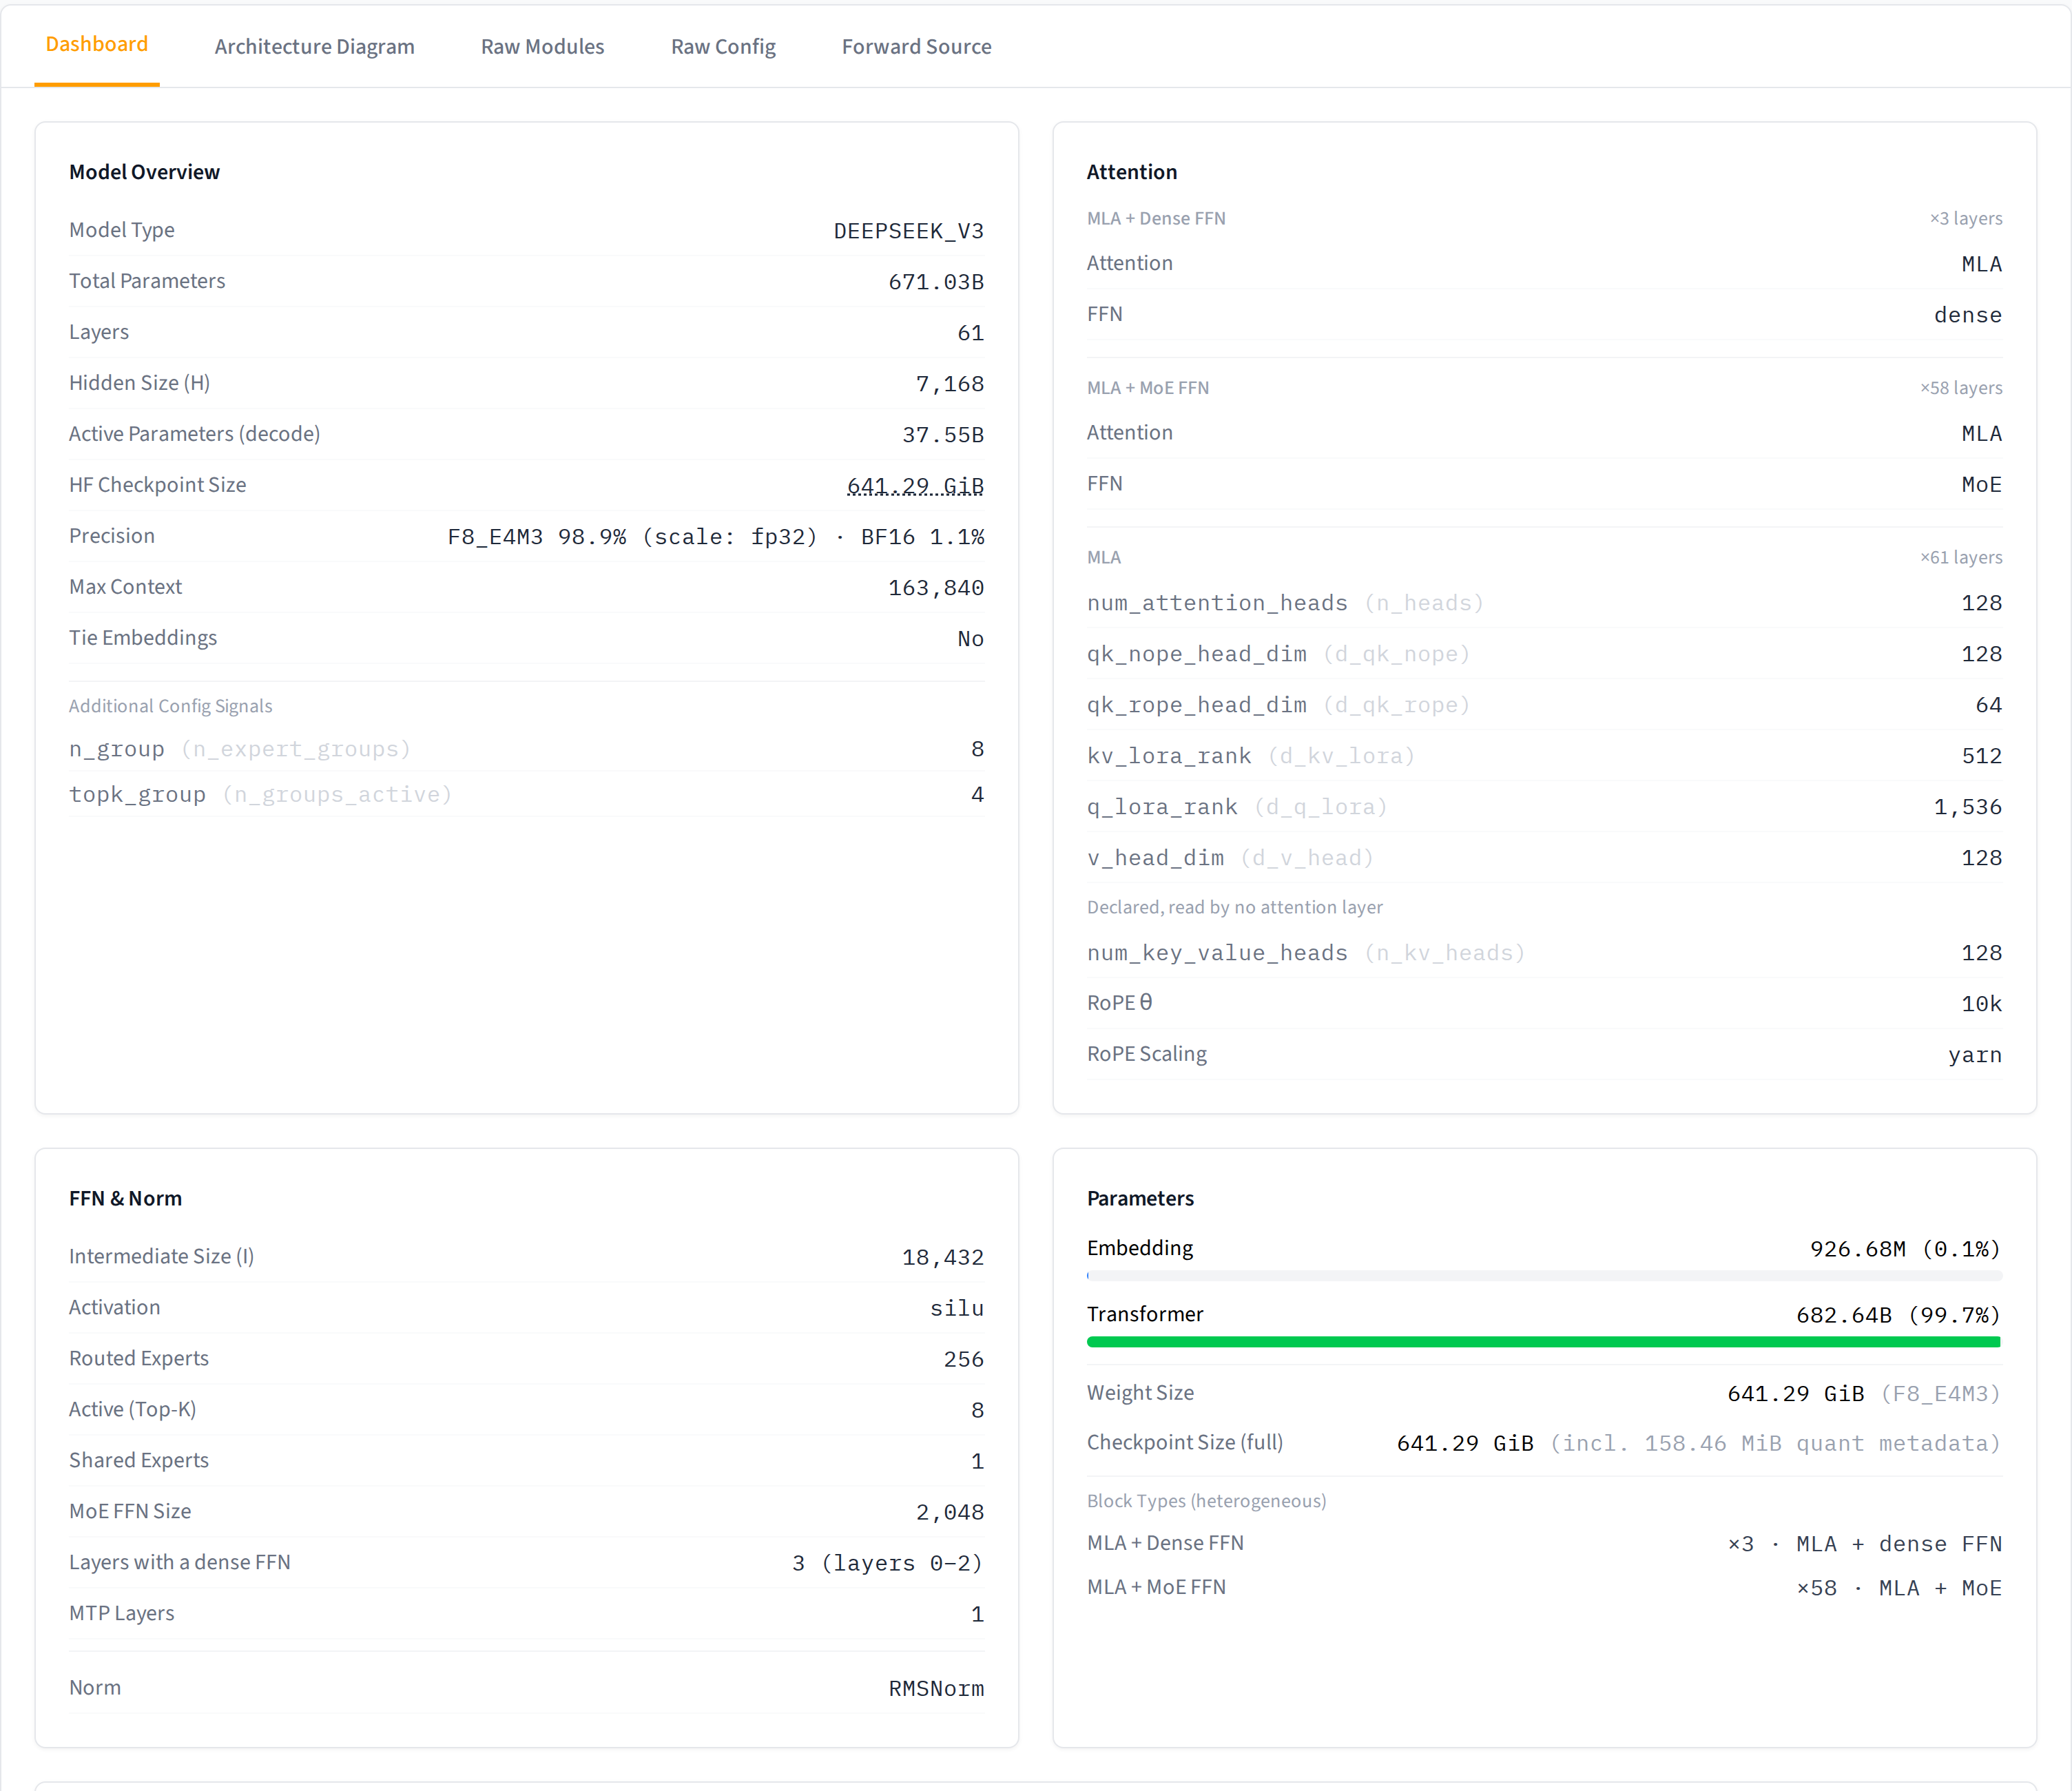
基本信息面板。 一屏给出模型的概况:类型、层数、隐藏维度、总参数和 decode 时的激活参数、checkpoint 大小和精度构成、最大上下文;注意力按层类型分组列出关键维度(MLA 的 kv_lora_rank、qk_rope_head_dim……),每个维度旁边注明它在 spec 里的符号名;FFN 和 MoE 的专家数、激活数、哪几层是 dense;参数在 embedding 和主干之间怎么分布,以及权重大小和 checkpoint 实际字节的对照——这正是 2.5 节对账的结果。
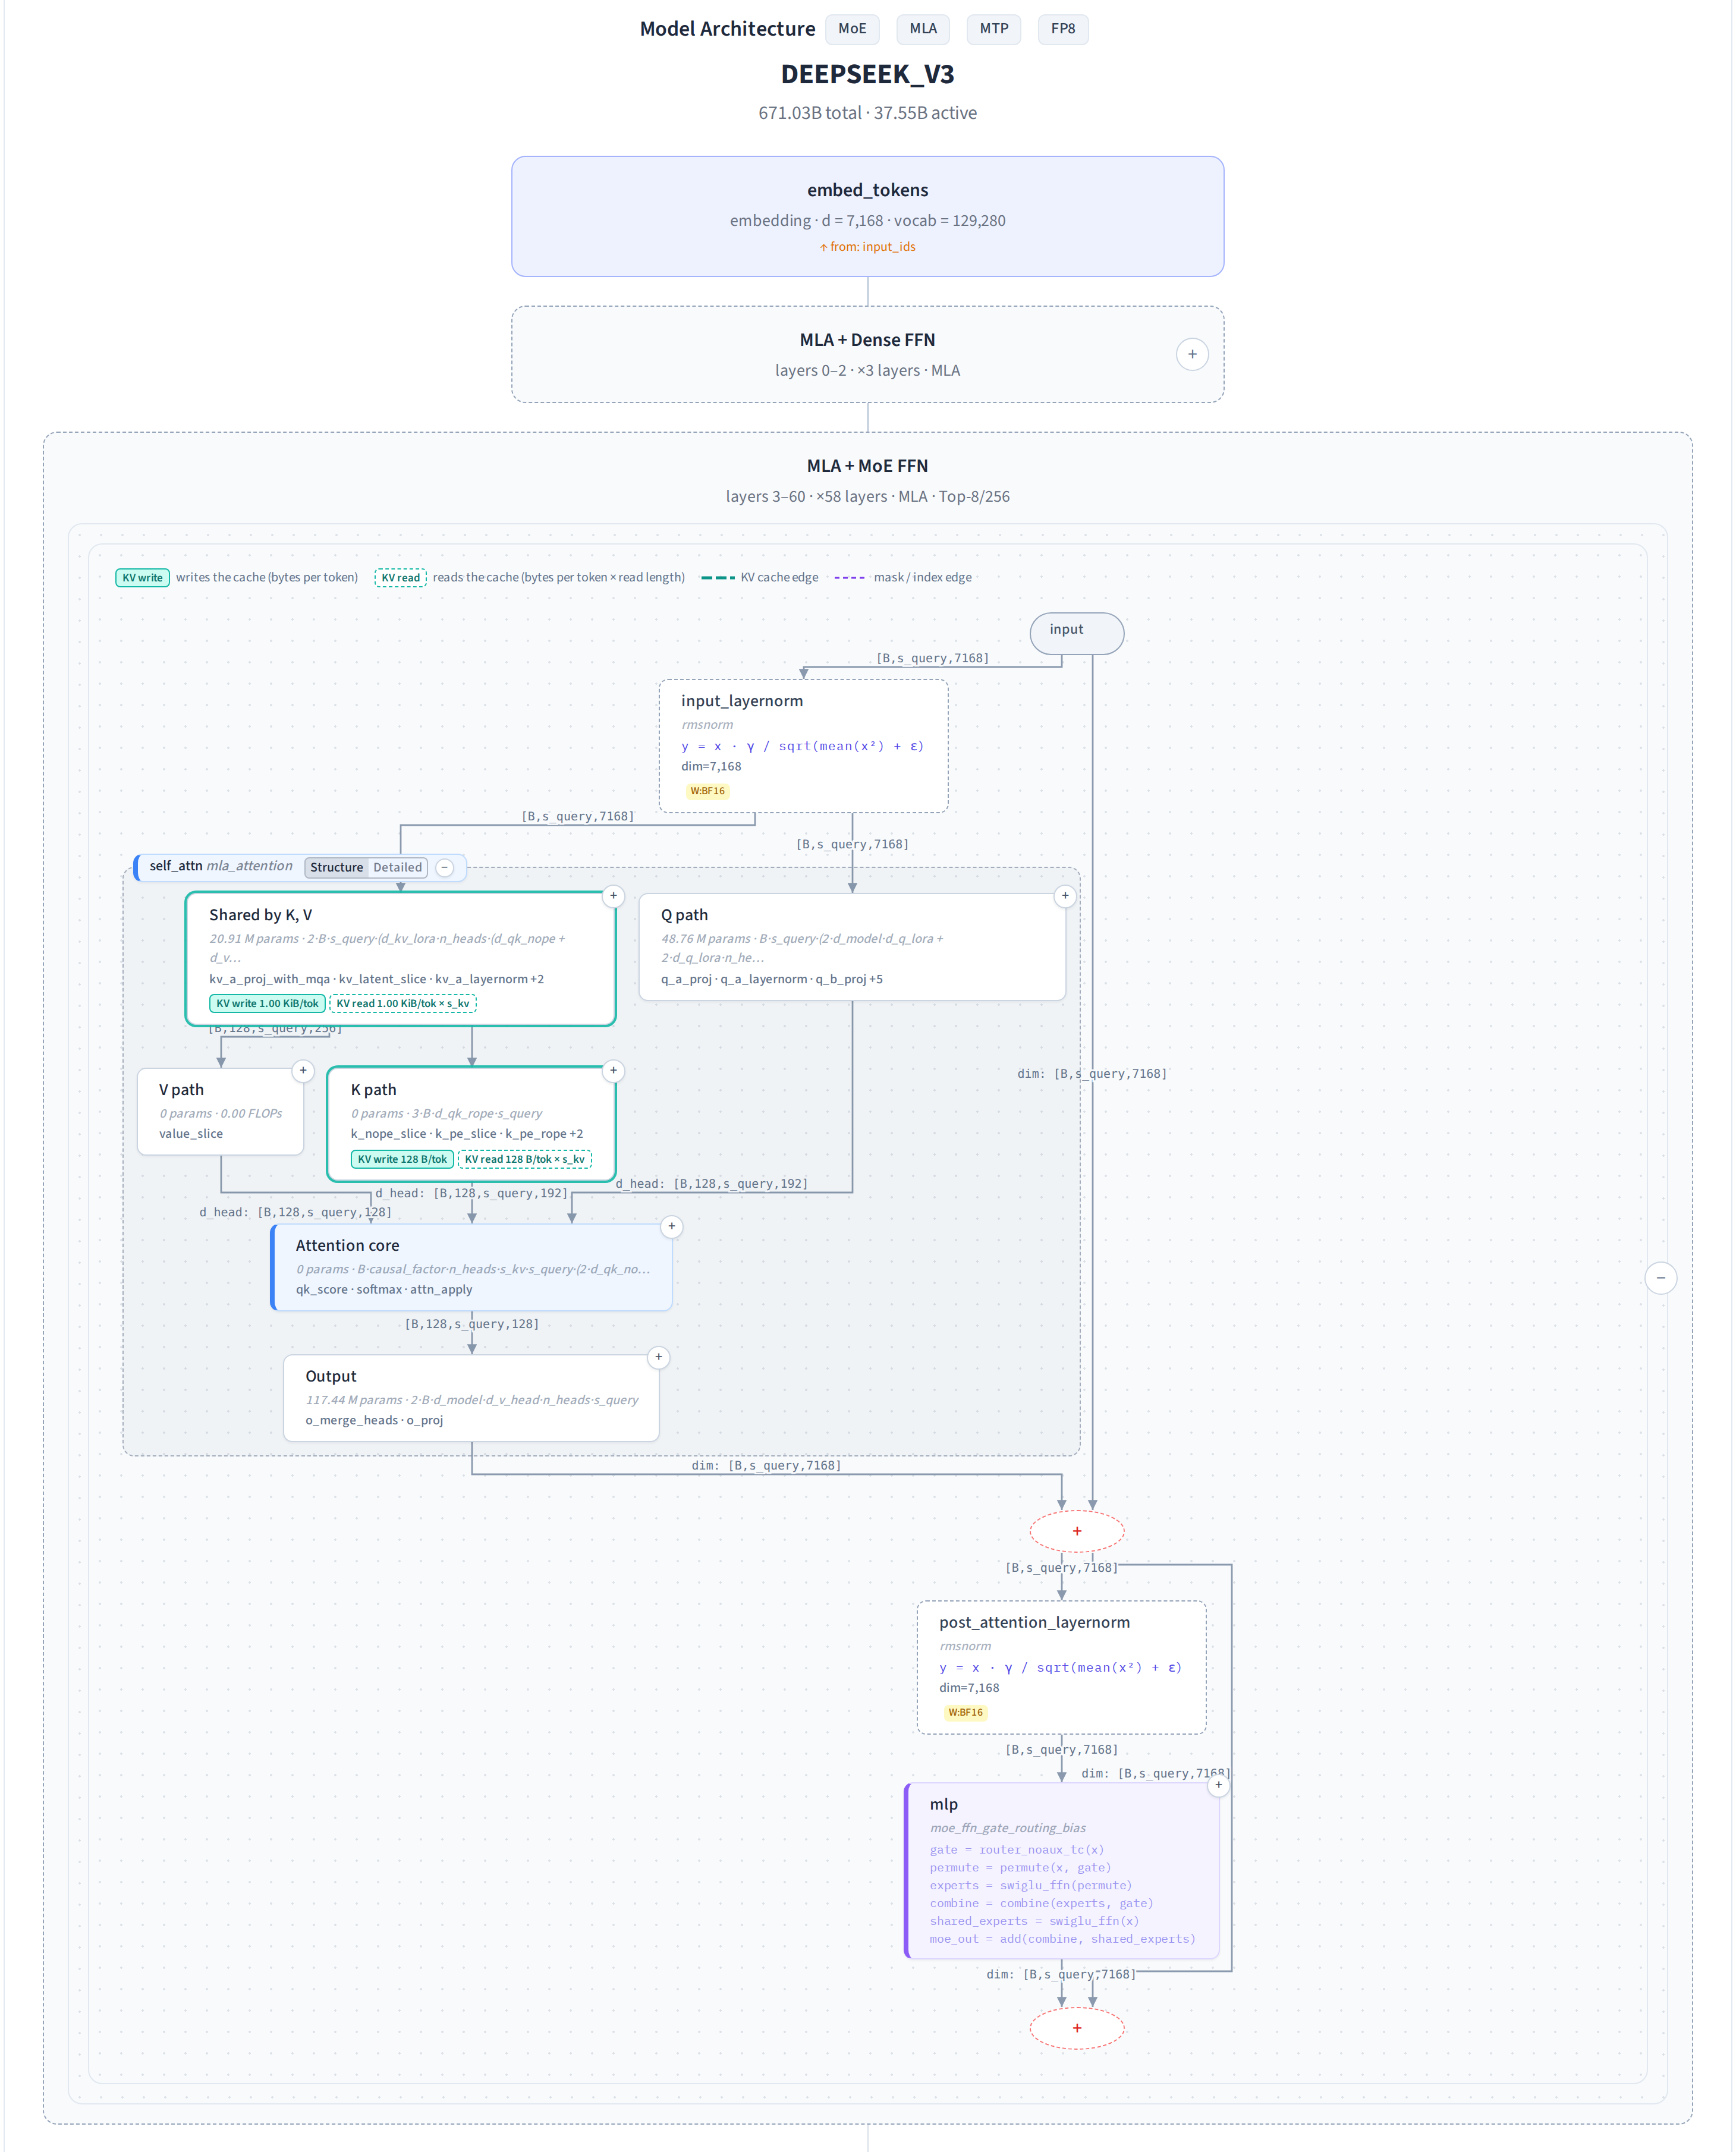
模型结构图。 spec 被展开成一张可以逐层点开的计算图:先看到 embedding、各类 block、norm、lm_head 的概览;点开一个 block,能看到注意力、norm、MoE、残差相加怎么连,每条边标着张量形状;再点开注意力,MLA 内部按数据流分成几条路径——K、V 共用的压缩 latent 路径、Q 路径、带 RoPE 的 K 路径、V 路径、注意力核心和输出投影,每一块都标着参数量和 FLOPs 公式,缓存节点上还标出每个 token 写入和读取多少 KV(latent 每 token 1.08 KiB,rope key 128 B)。这张图不是静态图片,而是同一次求值的结果画出来的。
权重与成本拆解。 按 block 列出参数量(注意力、FFN、专家分开)、激活参数、存储字节按 dtype 和量化 scale 的拆分,以及每个 token 的 KV cache,最后一行是整个 checkpoint 的合计。点进具体的块还能看到逐算子的 FLOPs、字节和算术强度,每个数字悬停都能看到公式——它是怎么从模型的真实维度算出来的。数字和公式出自同一次求值的两种绑定,所以永远对得上。
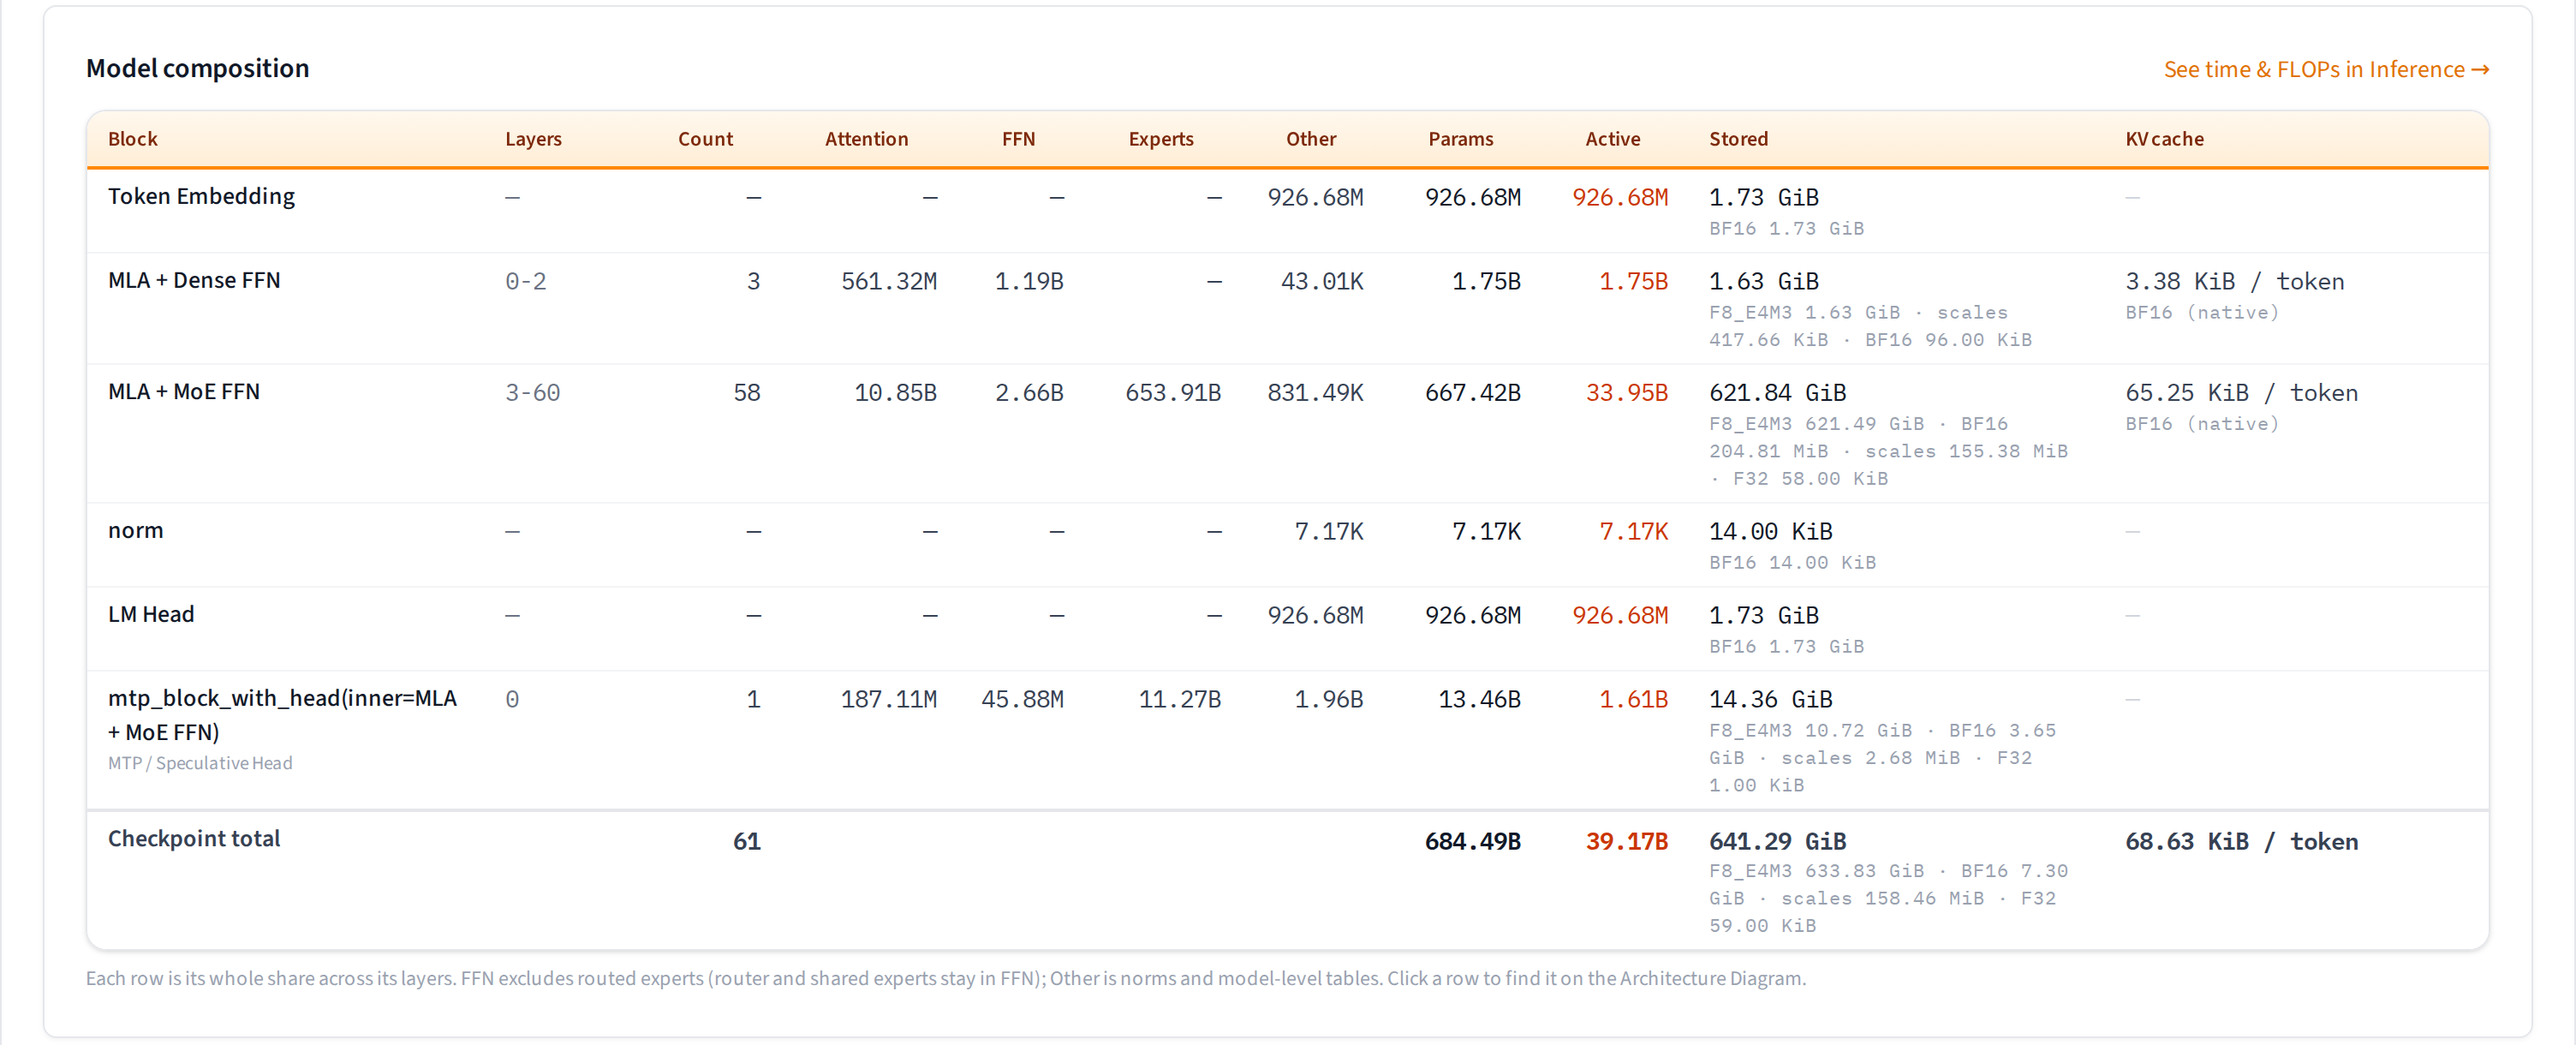
切到对比模式,可以把两个模型并排,逐 block 比较注意力类型、KV cache 和参数分布。跨整个模型库的横向比较、以及部署算账,在 Gallery 和推理页里,见第三章。
三、构建 Inference 算账系统
基于这份可信 spec 与贯穿三层的 sympy 双轨求值,"某个模型在某张卡上能否部署、如何部署"即成为 spec 之上的应用层——无需修改 modeling 代码,所有数值均由同一棵表达式树派生。以下五节对应这套成本估算系统的五个机制层:推理框架如何将多个 op 融合为单个 kernel(Fusion)、部署方案如何将张量切分到各设备(并行切分)、切分后各设备实际执行的形状如何导出(Shape 系统)、基于 SOL 的 prefill/decode 吞吐与容量如何计算(SOL 吞吐预测),以及如何用实测将 SOL 上界修正至可达吞吐(实测算子库驱动)。
3.1 从 spec 到数字:一次求值的几个层次
讲具体机制之前,先把骨架交代清楚。一份 spec 变成最终的数字要经过几层,每层只回答一类问题:
| 层 | 是什么 | 回答什么 |
|---|---|---|
| SpecIRTree | YAML 展开后的完整图:节点、边、role、跨层 stream、层序。YAML 只在这里读一次 | 有哪些算子,怎么连 |
| Program | 走访日程:走哪条 stack,每一步是单个算子还是"某个 block × N 层"。同一个 block 模板只算一次,再乘以层数 | 按什么顺序算,每样算几份 |
| Analysis | 带着部署方案(并行、精度、batch、context)走一遍得到的全部结果:形状、FLOPs、字节、KV、每卡切分。数值和公式是同一次走访的两种绑定;并行切分是走访时顺带传播的一条规则,不另造一张图 | 这一跑的每个数 |
| 图改写 | 在 Program 的一份拷贝上,先按切分方案插入通信,再按推理框架做融合(见 3.2、3.3)。只改结构,不重新求值,数字仍从 Analysis 取 | 实际会跑哪些 kernel |
之后的渲染、校验、容量估算、Playground 都只读这几层,不各自回头解析 YAML 或原始 config。同一个事实只有一个出处,不同页面上的数字才不会互相打架。
Analysis 内部的一个小设计:一组表,而不是一棵树。 直觉的做法是给每个节点挂一个对象,里面塞二三十个字段。Analysis 反过来,按事实的种类分表,每张表都以节点编号为键:形状一张、FLOPs 一张、权重存储一张、量化格式一张,还有一张"实例数",记录这个节点在整个模型里有几份——一个 block 模板只算一次,但模型里重复 61 层;一个专家只描述一份,但模型里有 256 个,每个 token 只激活其中 8 个。表里的 FLOPs、字节都是"一份"的量,乘上实例数才是全模型的总量。于是问"attention 一共占多少参数",就是把参数表、实例数表和 role 表按节点编号连起来再分组求和,像查数据库一样。
表里只放走访时必须当场确定的东西:形状和切分状态(要沿着图一路传下来)、FLOPs 和缓存声明(要知道当前模板绑定了哪些维度)、量化格式和实测耗时(从外部按节点对齐进来)。凡是能从这些表算出来的量——访存字节、KV 占用、容量、与 checkpoint 的对账——一律不另存一份,用到时现算。比如 KV 占用,就是缓存节点的形状 × 每个元素的字节数 × 实例数,随时能从表里算出来。
之所以坚持不存,是因为一个量如果既能从形状算出来、又另存了一份,两份之间就没有任何机制保证一致:哪天改了形状推导、忘了改存下来的那份,两边就悄悄对不上,而且不会报错。都从形状现算,就只有一个出处;图连错一条边,所有派生数字会一起跟着变——3.5 节说的"图错误能被检测出来"就靠这一点。完整论证见 docs/evaluation_model.md。
3.2 Fusion
Spec 描述的是数学意义上的计算图,但真实的推理框架会把一串算子融合成一个 kernel:spec 里分开的 Q、K、V 三个投影,在 vLLM 里可能就是一次融合的矩阵乘。HuggingArch 把"框架怎么融"显式建成一张表:每条融合规则描述一段可以合并的算子拓扑,每个框架(vLLM / sglang,按版本)声明自己实际启用了哪些规则。这些规则都是从 vLLM 和 sglang 的源码里逐条整理出来的。
融合有两个讲究:
- 排在通信之后。 融合后的 kernel 没有自己的代价公式,它的 FLOPs 和访存就是被吸收的那些算子的加总;而通信本身也可能被融进去,比如 all-reduce 和紧随其后的 RMSNorm 合成一个 kernel。所以要先按切分方案插好通信,再做融合。
- 看条件,不只看拓扑。 算子连法对得上,框架也不一定真的融。比如 sglang 对 Qwen3-MoE 的注意力,能把 QK-norm 和 RoPE 合成一个 kernel,但只在 head_dim 是 64、128 或 256,RoPE 覆盖整个 head,激活是 BF16,跑在 CUDA 上(并且打开了对应的启动开关)时才这么做,否则还是分开的几个 kernel。这些条件写在融合规则旁边,匹配时拿这次求值里实际的维度、精度和 GPU 去判断。同理,prefill 和 decode 走的子图本身可能不同(比如 MLA 在 decode 时换成吸收版),所以两个阶段各融各的。
融合只改图的结构,数字仍从同一次求值里取。页面上,Inspector 画融合前的图,推理页的计算图画融合后的图,展开一个融合节点能看到它吸收了哪些算子;Fusion 页则列出某个模型在某个框架、某个版本上命中了哪些规则。这样 spec 就不止停在"理论算子图",还能对上"这个框架这个版本实际会怎么跑"。
3.3 并行切分:切分是沿图传播的状态,通信是推出来的
一个模型上多卡,切法是组合爆炸的:attention 按头切 8 份、MoE 专家分到 32 张卡、长上下文再叠一层 CP、层间还有 PP。如果每种模型、每种组合都手写"哪里切、哪里通信",很快就写不完,也没法保证写对。最朴素的"总量 ÷ 卡数"更不行——它说不出哪些张量在同一个通信组里,也说不出哪条边上要插通信。
HuggingArch 借的是 PyTorch DTensor(及其源头 GSPMD,Xu et al. 2021)的思路:切分是张量的一种状态,和形状一样沿着图往下传。 每个张量在每个并行维度上处于三种状态之一:
- Sharded:每张卡只有一份切片;
- Replicated:每张卡都有完整的一份;
- Partial:形状是完整的,但每张卡上的数值只是一个部分和,加起来才是真值。
Partial 是整套设计的关键:它和完整张量形状一模一样,光看形状永远发现不了;只有把状态一路传下来,才知道下游拿到的数还"欠一次求和"。
拿一层 TP 注意力走一遍:
q_proj      权重按头切(列切)        → 输出:按头 Sharded
attention   每张卡只算自己那几个头    → 输出:按头 Sharded
o_proj      权重按头切(行切)        → 输出:Partial(每张卡一个部分和)
+ residual  残差相加需要完整的值      → 状态对不上 → 自动插入 all-reduce
没有人在 spec 里写过"o_proj 后面接一个 all-reduce"。spec 只写了维度(o_proj 的输入是 n_heads * d_head),维度表说头轴归 TP 切;行切产生 Partial,下游要 Replicated,两者之差就是一次 all-reduce。通信不是写出来的,是从状态差里推出来的。 同一套规则换个地方用:Sharded 遇到要完整值的读者,推出 all-gather;token 要送到别的卡上的专家,推出 all-to-all;CP 下每张卡各算一段 KV 的注意力,合并时推出按 log-sum-exp 的归约。TP、EP、CP 不是三套机制,是同一套状态代数用在不同的边上。
上面那张走查里藏着一个问题:q_proj 的输出是一根扁平的 n_heads × d_head 特征轴,按头切开之后,还要经过拆头、转置、打分、合头好几步变形,切分状态凭什么还"跟得上"?靠的是每个算子的 DimMap——2.4 节形状推断用的同一张逐轴对应表,它说明输出的每根轴来自输入的哪根轴:原样搬过来、由一根轴拆出来、由几根轴合并,还是新产生的。切分沿着这张表走:
q_proj 输出  [B, s, n_heads·d_head]      切在最后一根轴(按头)
拆头         [B, s, n_heads, d_head]     这根轴拆成两段,切分落在"头数"那段,d_head 保持完整
转置 / 打分  [B, n_heads, s, s]          头轴原样搬过来,切分跟着走;d_head 被收缩掉,与切分无关
合头         [B, s, n_heads·d_head]      几根轴合并,切分回到合并后的轴上
规则只有几条:轴原样搬过来,切分跟着走;一根轴拆成几段,切分落在最外面那段(整头整头地分);几根轴合并,切分跟到合并后的轴;被收缩掉的轴,切分随之消失。形状推断和切分传播读的是同一张表,所以只要一个算子的形状对了,它的切分也就对了——不用为切分再给每个算子写一遍规则。这张表按轴的位置工作,不看轴叫什么名字,一个被写死成 64 的头轴和一个叫 n_heads 的头轴,处理起来完全一样。
这套做法还会自己推出一些"反直觉"的结论。MLA 缓存的是压缩后的 latent,它根本没有头这根轴,所以 TP 切不动它——每张卡都要存完整的一份,加大 TP 对 MLA 的 KV 占用毫无帮助;要把它分摊开,得靠 attention 的数据并行,让不同的卡处理不同的请求。这不是为 MLA 开的特例,是从维度表里直接读出来的。EP 也一样自然:它不切专家的形状,只减少每张卡上的专家个数(实例数),每个专家保持完整;专家内部再切,才是 TP 的事,两者相乘,不需要为"EP + TP"写任何特殊逻辑。
推出来的通信是图上真正的节点:它出现在逐算子的成本表里,带着自己的通信字节数,按所在通信组的拓扑选机内高速链路还是跨机网络计价,也能参与 3.2 节的融合(all-reduce 和后面的 RMSNorm 合成一个 kernel)。PP 同理:把重复的层切成连续的几段,凡是跨段的边就变成一次点对点发送——不只是主干的 hidden,跨层 stream(比如 DSA 共享的 top-k 选择)跨段时也会被自动算进去。
最后,每张卡上的形状、FLOPs、显存都是从同一次求值、按切分状态"读"出来的,不会为每种切法重新求一遍,维度的长度始终是全局的。这带来一个可以写成测试的性质:两种 CP 方案(Ulysses 和 pcp)通信方式不同,但每张卡持有的数据一样,所以每卡的访存字节必须相等——测试就是这么断言的。完整规则见 docs/parallelism.md。
3.4 基于 SOL 的 Prefill / Decode 吞吐预测
Intro 给出了单个算子的 SOL 时间
这一层不依赖任何 kernel 实测:它给出的是硬件 roofline 决定的下限时间,任何实现都突破不了;在同一个口径下,不同并行方案、不同 GPU、不同模型可以直接比较,不受 kernel 实现好坏的干扰——这正是 Intro 里"算账"最核心的诉求。
下面以 DeepSeek-V3 在 8 张 B200 上(attention 数据并行 + 专家并行,输入输出各 1024 token)为例:
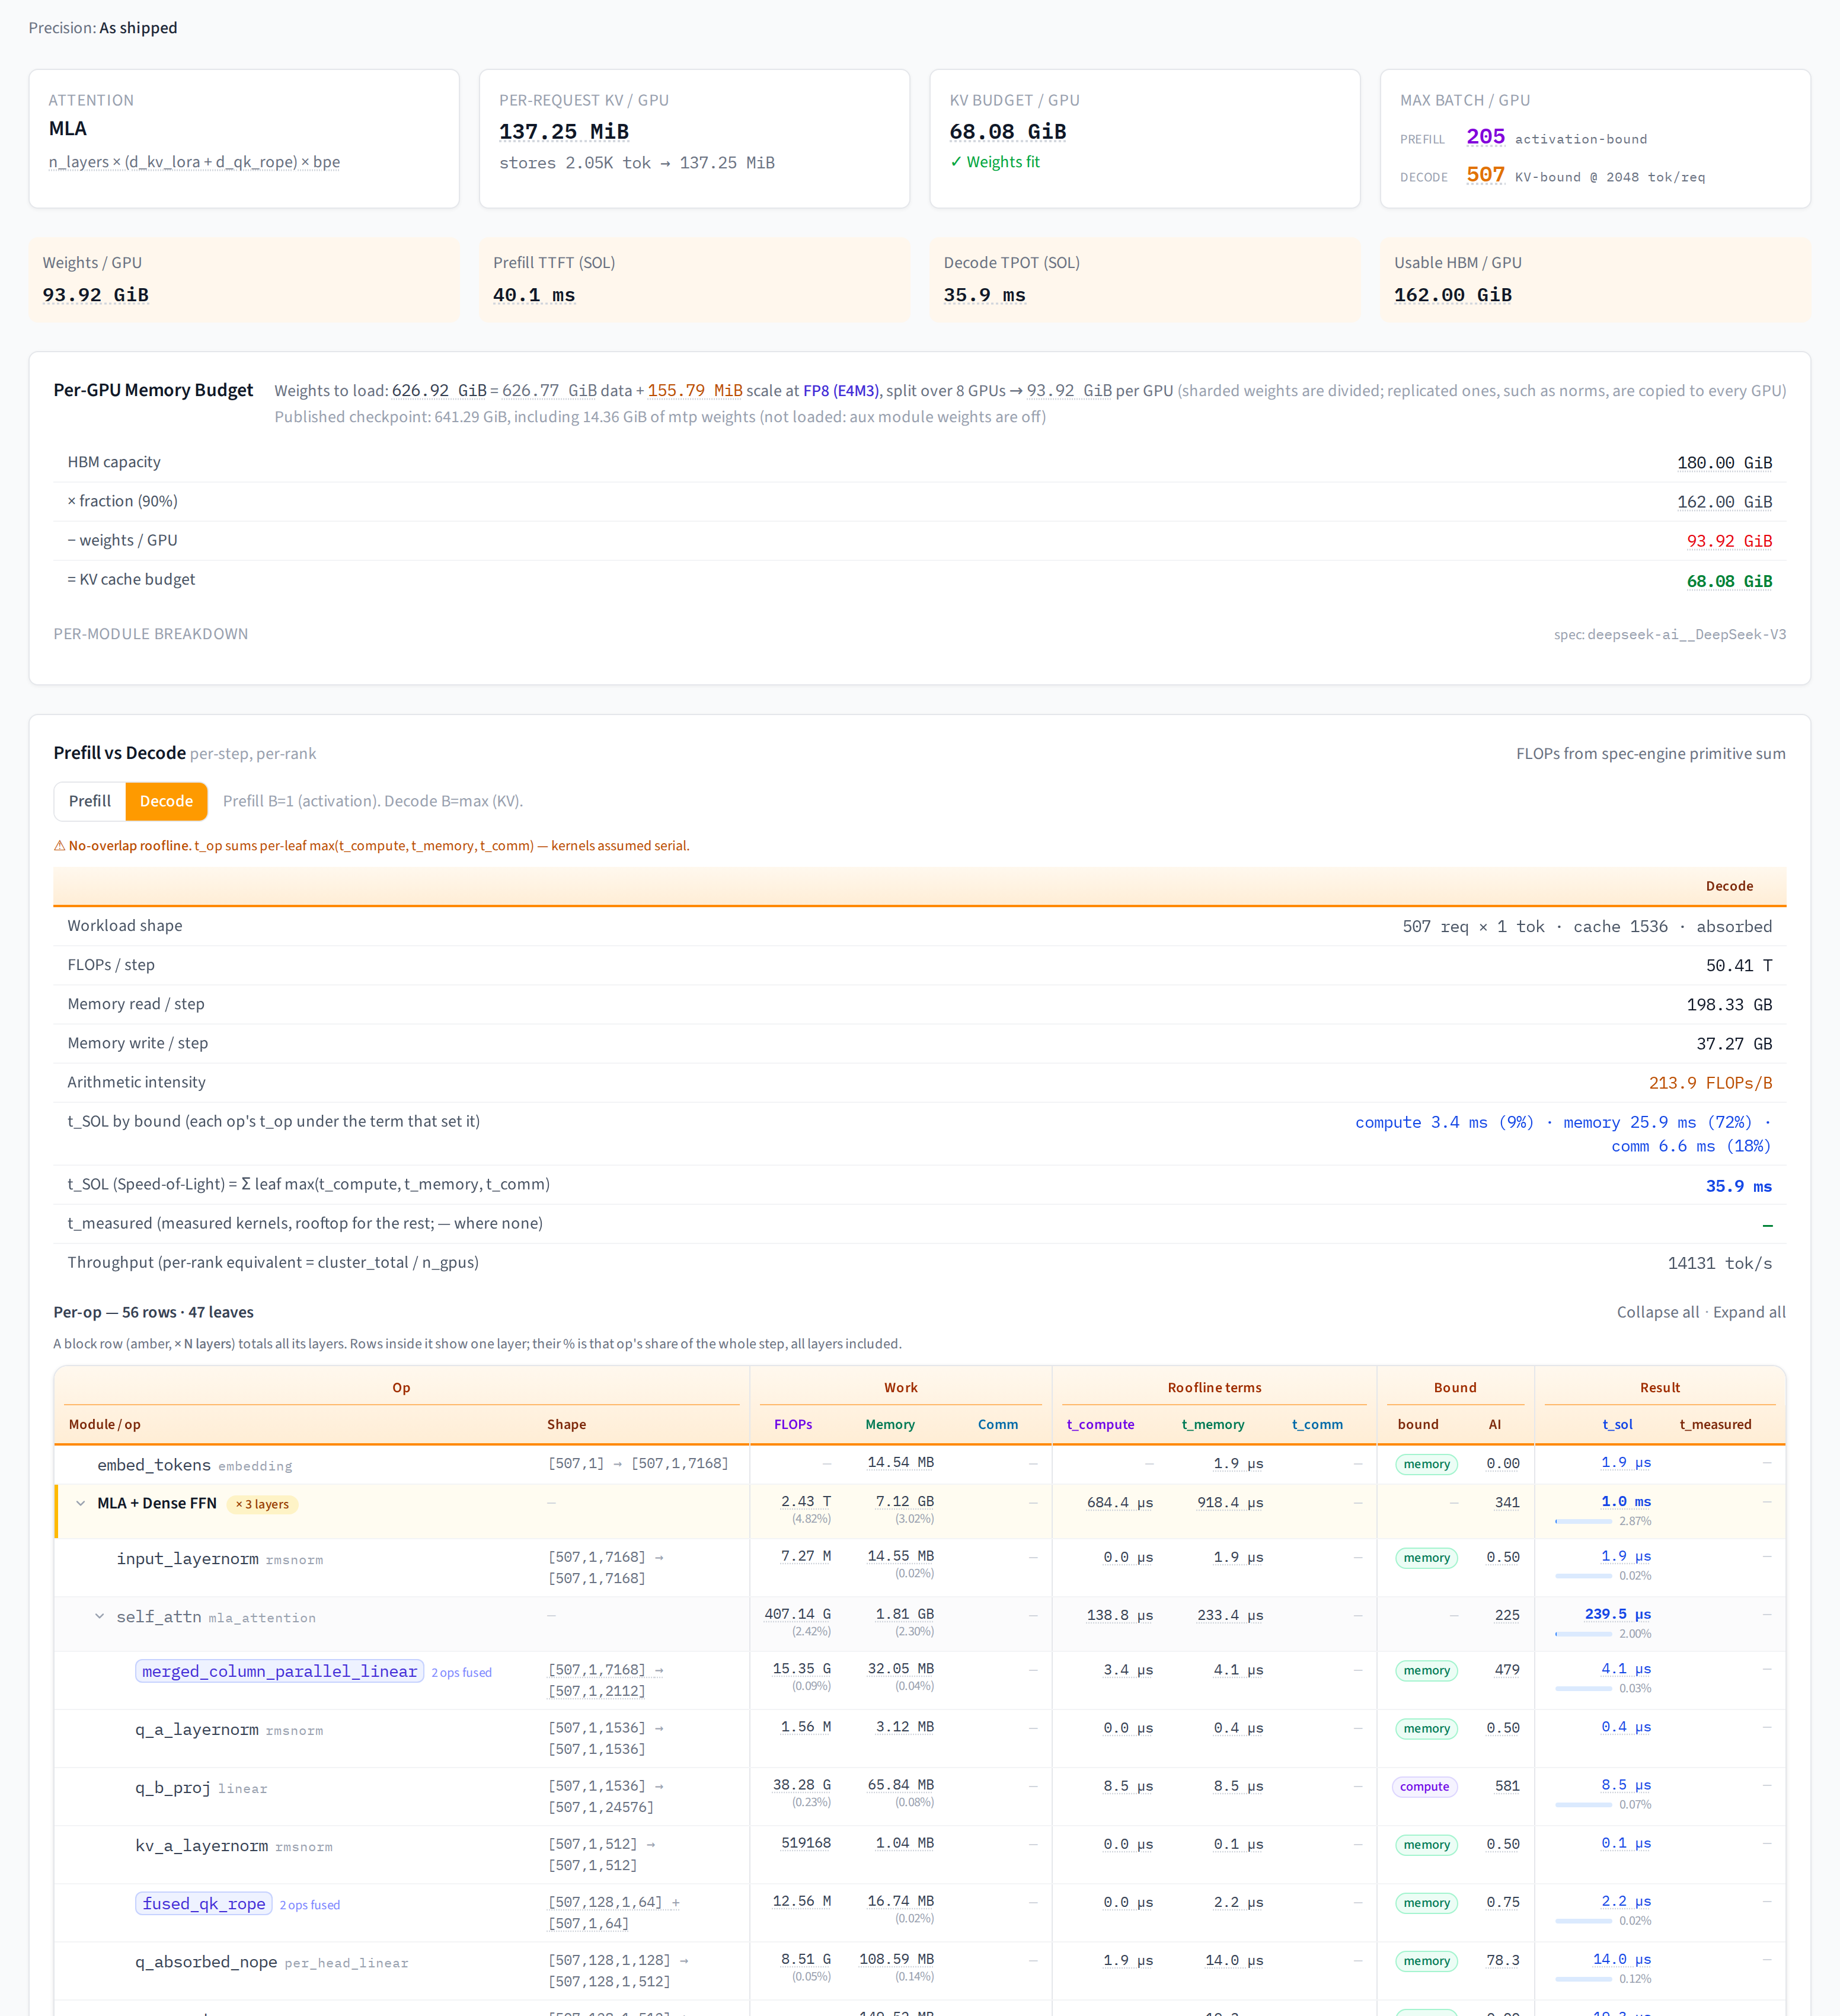
显存:先放权重,剩下的给 KV。 B200 每张卡 180 GiB,按 90% 可用算 162 GiB;权重按切分方案摊到每张卡是 93.92 GiB——字节数来自 2.5 节那份和 checkpoint 对过账的存储表,FP8 权重、少量 BF16 和量化 scale 各算各的;剩下的 68 GiB 是 KV cache 的预算。KV 按每条缓存张量自己的规律记账:GQA 的 K、V 逐 token 增长,MLA 只存压缩后的 latent 加一份共享的 rope key,滑窗封顶在窗口长度,线性注意力和 SSM 的循环状态不随上下文增长;一层还可以同时挂几条规律不同的缓存(DeepSeek-V4 的一层同时有滑窗 KV、压缩 KV 和索引键,各算各的,完整模型见 docs/kv_cache_storage.md)。落到这个例子上,每个请求的 KV 是 137 MiB,decode 最多放下 507 个请求,瓶颈是 KV;prefill 的 batch 先被激活值卡住,只有 205。
时间:逐算子取瓶颈,再相加。 每个算子分别算三项——算力时间、访存时间、通信时间——取最大的那项作为它的 SOL;一步的时间是所有算子之和,不假设 kernel 之间能互相重叠。图中下半部分的逐算子表就是这么来的:每一行标出这个算子是被算力还是访存卡住、算术强度多少,融合后的 kernel(3.2 节)和插入的通信(3.3 节)也各占一行。汇总起来,这个配置下 decode 一步 35.9 ms:72% 的时间花在访存、18% 在通信、只有 9% 在计算,是典型的带宽受限;TTFT 40.1 ms,折合每卡约 1.4 万 token/s。
扫描:一个点不够,要看曲线。 推理页顶部的 Scaling 面板把同一套估算沿几根轴扫开:固定 4K 上下文,把专家并行从 4 张卡扫到 256 张,比较不同 GPU 的每卡吞吐;固定 8 张 B200,扫 batch × 上下文长度,看 prefill 和 decode 的吞吐怎么变;再单独看每个请求的 KV 随上下文怎么涨、一张卡最多能放几个请求。超过模型公布的上下文上限(V3 是 163,840)的点会明确标出来——它们是外推,不是模型真能服务的范围。
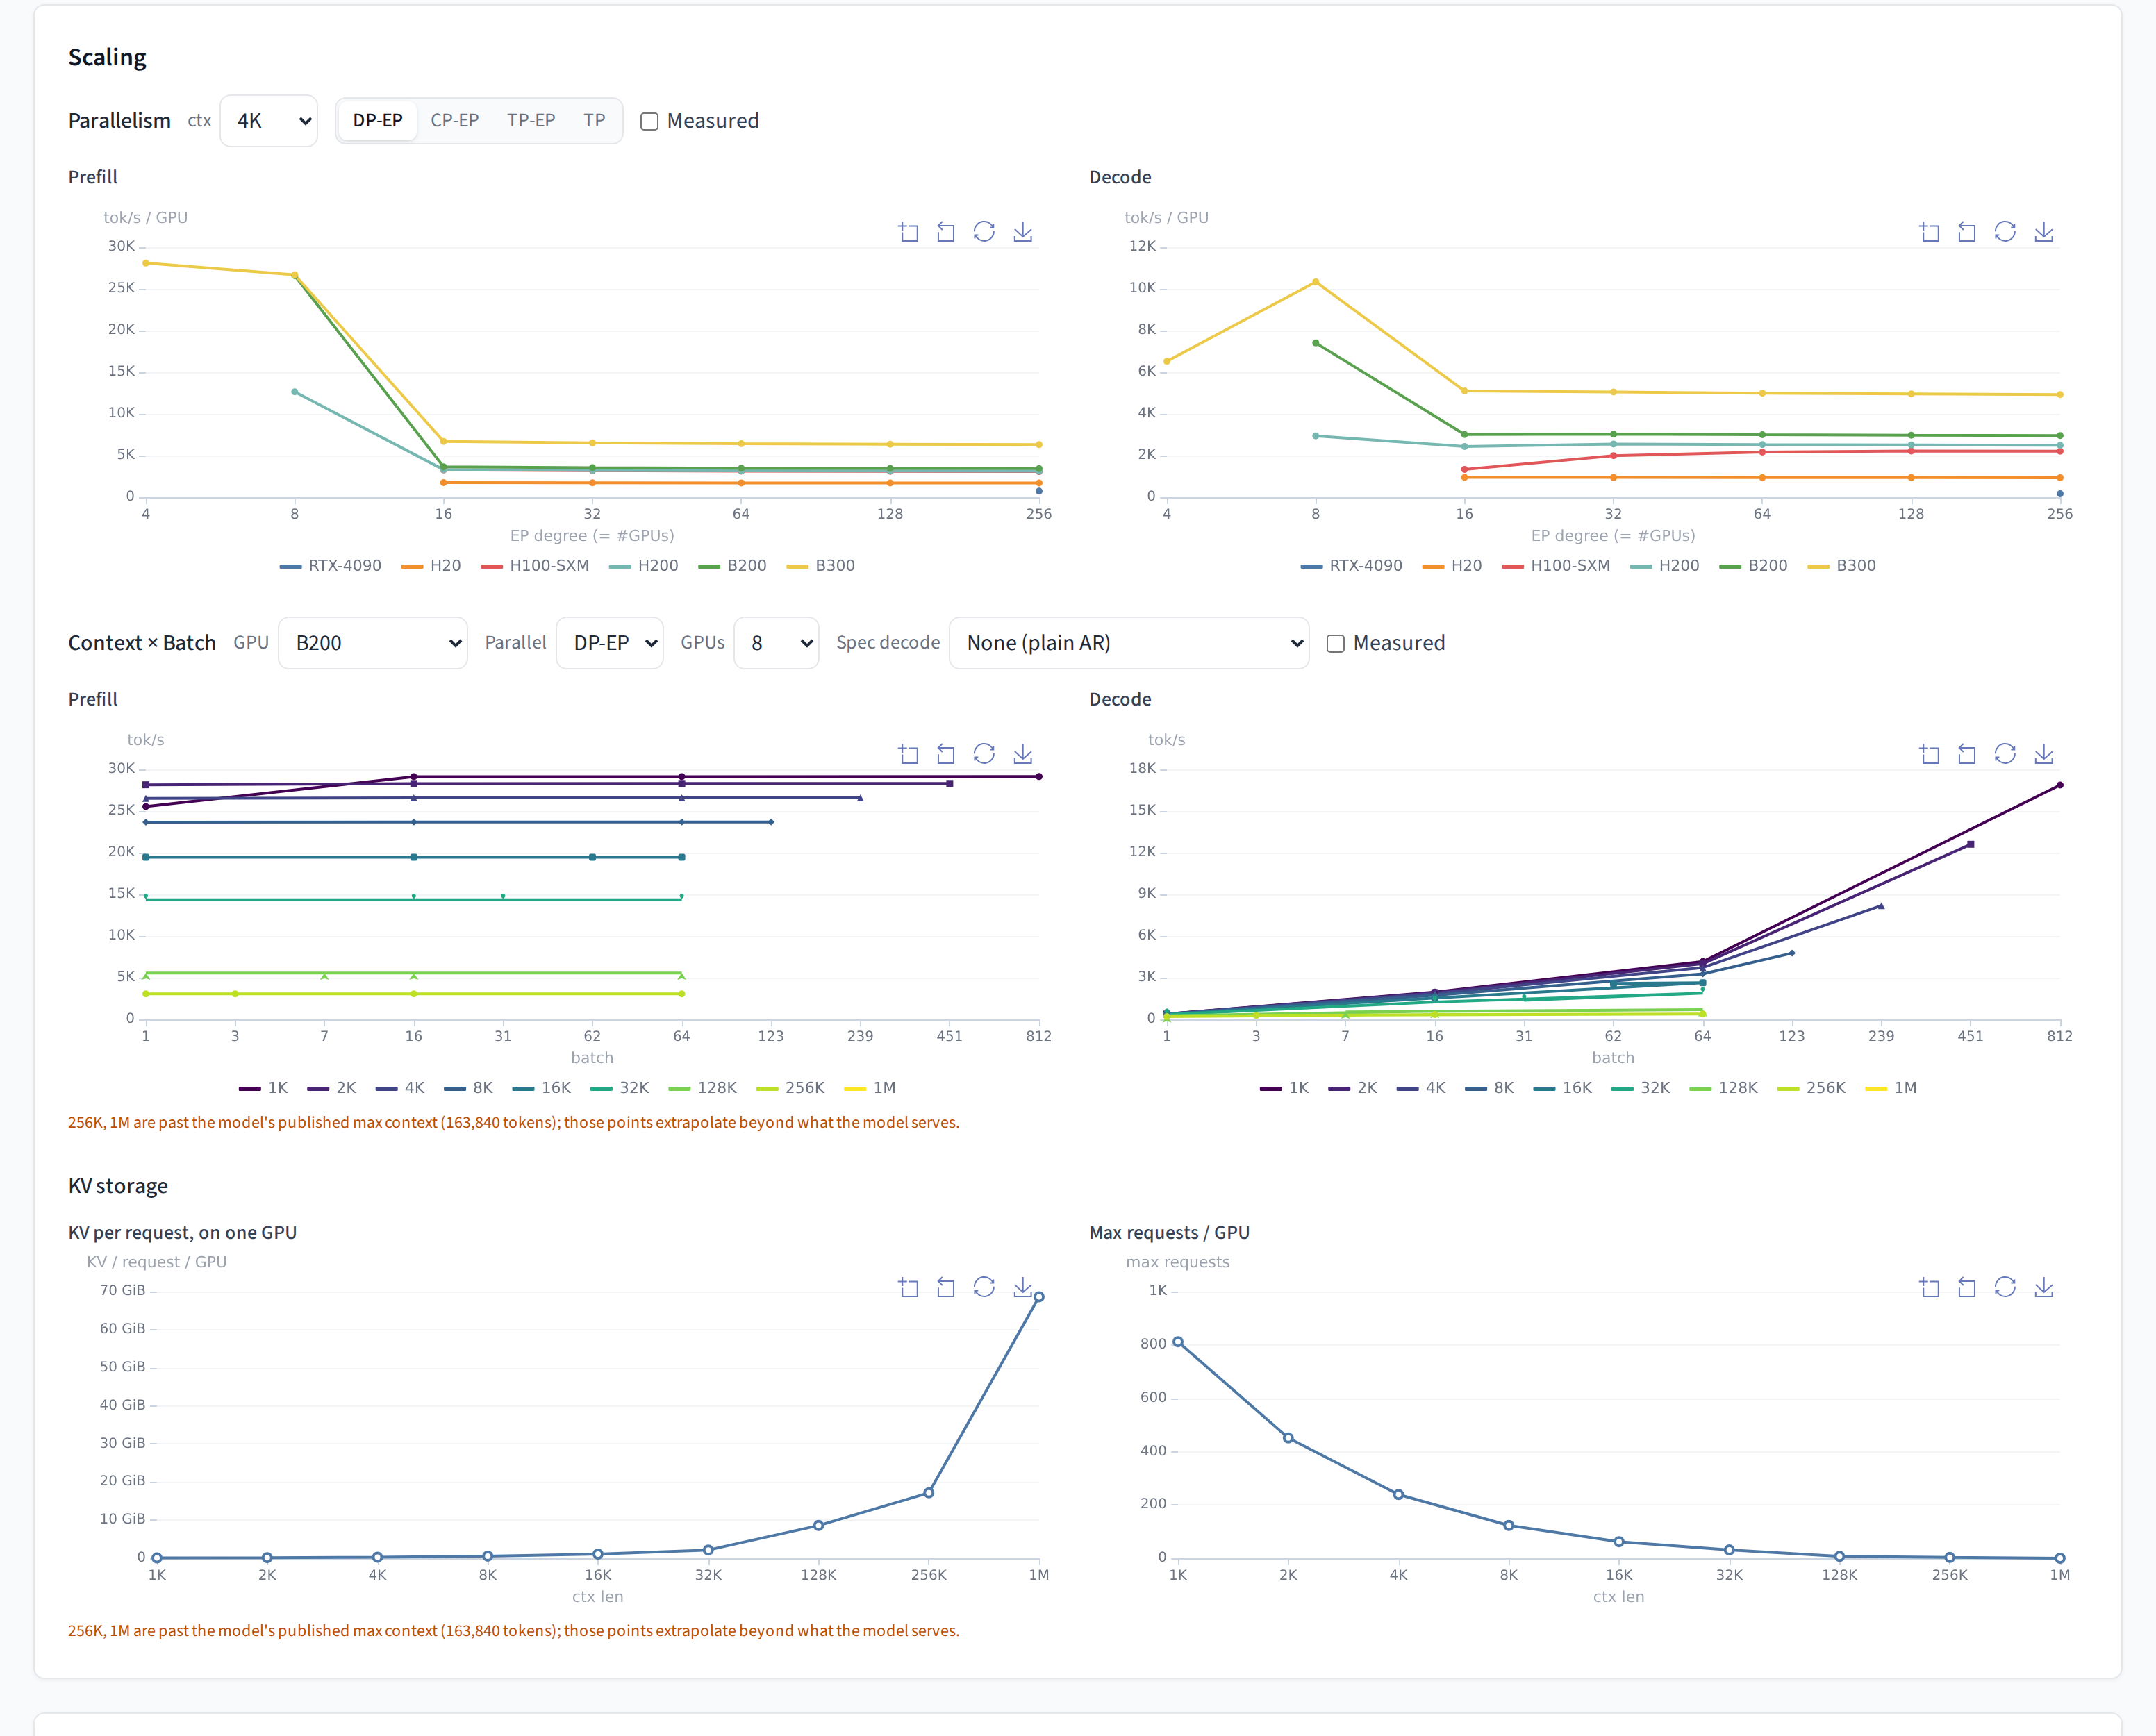
以上完全基于 SOL,没有一次 kernel 实测。真实 kernel 只能达到上界的一部分,后两节讲如何用实测把它修正到可达的吞吐——但这不改变 SOL 作为跨模型、跨方案对比基准的地位。
3.5 Shape 系统:所有派生量共享同一份形状推导
回头看,整个算账系统的基础事实其实只有两个:参数量以 checkpoint 里张量的实际形状为准,而其余所有派生量都来自同一次形状传播的结果——flops 的维度取自传播到该节点的实际轴长,HBM 读写字节按各条边上的张量形状计算(融合后省掉的中间量也是从融合边界的形状直接读出的),KV cache 按每条缓存张量各自的存储规律随形状展开,每张卡上的几何由这次遍历带上的 layout 折算得到,维的长度保持全局,不再把并行度除进绑定后重跑一张图。我们刻意不为任何派生量维护第二份独立的计算路径:早期版本里确实存在过(一份按模块类别查表的切分系数、一条按环境维度数 flops 的旁路),实践中它们都会随着代码演进逐渐偏离形状推导的结果,而这种偏离不会触发任何报错。
把 flops 也收敛到形状推导之后,出现了一个当初没有预期到的收益:不少 spec 图错误会表现为可检测的数值或几何差异。比如把一个分组 einsum 误建成稠密全连接、把某个四维张量的轴序接反、把 lm_head 的输入边误接到一个标量门控上,可能使 flops、字节数或 shape 诊断偏离。我们在 DeepSeek-V4-Pro 和 Kimi-K3 的 spec 中各自发现并修复过这样的错误,判定依据都是 checkpoint 中对应张量的实际形状。但这不是完备性保证:shape 检查只证明张量拼得起来,仓库也没有覆盖所有等价拓扑的 checker。
从部署方案到每张卡的真实形状
要把 SOL 上界修正到真实实现,第一步是知道每张卡上每个 op 实际执行的形状——这需要一个可靠的 shape 系统。它与第二章 的 shape 推断复用同一套机制:遍历仍按全局长度求形状,layout 在边上记下每张卡拿哪一块,本地形状是读的时候折算出来的,不是另绑一套除掉的维再求一遍。
具体地,一个合法部署方案(ParallelConfig)决定哪些轴被哪些进程组切开——attention 的 n_heads 归 TP、dense / expert 中间维同样、EP 切 expert 份数 n_expert_copies 而不动路由分母 n_experts。维的长度仍是全局的;每张卡拿多少,是 layout 在读的时候给出的格子,不是绑定里先除掉再求一遍值。LayoutPropagation 顺着遍历记下每条边的布局,本地形状、FLOPs、访存从同一份 Analysis 折算得到。这是"一次遍历、布局管每卡"的核心:无需为任意 TP / EP / CP 组合单独编写推导逻辑。
如此得到的形状即为各设备上真实执行的规模——例如 DeepSeek-V2-Lite 在 tp_ep8 下 grouped_gemm 的 K 为 1408,可直接作为下节实测的输入。它与第二章 的 Shape inference 用途互补:第二章 在构建 spec 时以其做几何一致性校验,此处以其将一个部署方案正向推导为各设备的真实 kernel 形状。placement 代数的细节见 docs/parallelism.md。
一个可靠的 shape 系统还带来一个关键收益:由于它能从部署方案正向推导出分布式部署下每张卡的真实 kernel 形状,只需在单张卡上以该形状 profile 一个算子,即可得到通常要真正搭建大规模分布式集群才能测到的 kernel 性能。换言之,用最轻量的单卡实测覆盖分布式部署的算子成本——这也是下一节实测的前提。
3.6 基于实测的算子库驱动:把上界修正到可达
SOL 是上界。真实 kernel 只能跑到峰值的一部分,而且哪个 kernel 最快,取决于形状、dtype 和所用的库。3.4 节回答的是"最好能多快",这一节回答"今天实际能多快"。
参照的不是某一个框架,而是整个生态里最快的正确 kernel。 同一个算子,FlashAttention 2/3、FlashInfer、FlashMLA、DeepGEMM、FLA、Mamba-SSM、vLLM、sglang 往往各有实现。HuggingArch 不偏向任何一家:每类算子定义一份数学契约,规定它要算什么;每个库的 kernel 以 adapter 的形式注册到这份契约下,声明自己支持哪些形状、怎样把标准输入转成自己的布局。测量时,同一个形状上所有适用的 kernel 都跑一遍——新出一个 kernel,不过是多一行数据。
先验对,再比快。 每份契约都配有一个 PyTorch eager 写的参考实现。kernel 的输出转回标准布局后,与参考实现按 dtype 定的容差比对(FP8 宽、BF16 中、FP32 严),对不上就不记录——"最快"不能由一个算错的 kernel 赢得。留下来的数还要过一道物理检查:由它推出的算力利用率(MFU)和带宽利用率(MBU)不能超过 SOL,超了只能说明测量本身出了问题。
测的是每张卡上真实跑的形状。 3.5 节从部署方案正向推出了每张卡上每个算子的真实形状,测量计划直接从这里生成:给定模型和一组 batch / 上下文,列出一次真实推理会命中的全部 kernel 形状,去重后在单卡上逐个测。分布式部署下的 kernel 成本,因此不必真的搭一个集群去测。(集合通信是例外:它天生需要多卡,目前还不在这条单卡流水线里。)
实测与 SOL 并排,不互相覆盖。 实测时间放在 3.4 节那张逐算子表里 SOL 的旁边:读者既看得到上界,也看得到今天的实现离上界还有多远。默认取所选推理框架自己的 kernel 在语料里最新版本的测量值,并注明是哪个版本;也可以切到"包络"模式,取任意库里最快的那个。没有实测数据的算子,继续用 SOL。
支持的库和 kernel 清单见 docs/measured_calibration.md。
3.7 Kernel Bench:把算子测速变成一个数据库
我觉得一个以数据库为中心的 Kernel Bench 本身就很有意义。实际工作中经常要给 kernel 测速,测出来的结果却往往零散地躺在各种文档、表格和聊天记录里:测的是什么形状、什么 dtype、哪个版本的库、在哪张卡上,事后很难说清,更没法和别人的结果放在一起比。
HuggingArch 给每一次测试一个完整的 workload 签名:算子类型、这个算子关心的形状、dtype、GPU、prefill 还是 decode、并行方式,再加上库名、版本和 kernel 名。有了这个签名,所有测试数据就能像数据库里的行一样被系统地存放、查询和比较。整个流程是这样的:
- 生成测试目标。 从一个模型和一组 batch / 上下文导出测试计划,也就是一次真实推理会命中的全部 kernel 形状(见 3.6 节)。
- 本地测速。
hbench命令行在你自己的机器上为每个算子库准备隔离的环境(各家依赖经常互相冲突),调用对应的 provider 逐个测速;每一行结果都盖上实际安装的库版本。版本是数据的一部分,结果只追加、不覆盖。 - 校验。 每个结果先和参考实现比对数值,再检查 MFU / MBU 有没有超过硬件上限;不过关的结果不会离开本机。上传之后,云端还会再算一遍,把异常的行标出来。
- 上传与管理。 上传的数据默认私有,只校准你自己的估算;想贡献给所有人,就提交审核,管理员通过后并入共享语料。网页上可以浏览、筛选、可视化全部历史数据。
这样一来,同一个算子的所有实现可以横向比较,同一个 kernel 在不同框架版本上的表现也可以横向比较。算子测速不再需要人一遍遍手动跑、手动记:算子开发者可以专注于 kernel 本身的性能优化,推理引擎开发者也能直接从这里找到当前最好的实现。命令行的完整用法见 kernel_bench/README.md。
四、Model Arch Design:在 spec 上设计模型
spec 把模型拆成了可复用的 component,这让 HuggingArch 不只能分析已有的模型,还能回答"如果换一个模块会怎样"。Playground 提供两种玩法:把同一个位置上的几种模块拉出来横向对比;或者从一个已有模型出发,换掉其中的模块,看整个模型的账怎么变。两者的数字都和 Inspector、推理页出自同一套求值,不是另写的估算。
4.1 模块对比:同一个位置,五种注意力
这两年注意力的花样最多。以 DeepSeek-V3 的 MLA、DeepSeek-V3.2 的 DSA、DeepSeek-V4-Pro 的 CSA 和 HCA、Kimi-K3 的 KDA 为例,把它们放到同一张对比表里。每个模块都按它在原模型里的样子绑定内部维度(头数、latent 宽度、窗口、压缩比……),再放进同一个固定的契约下比较:相同的隐藏维度(7168)、batch、序列长度和 GPU。所以这里比的是"把它原样换进同一个位置的代价",不是架构排名。
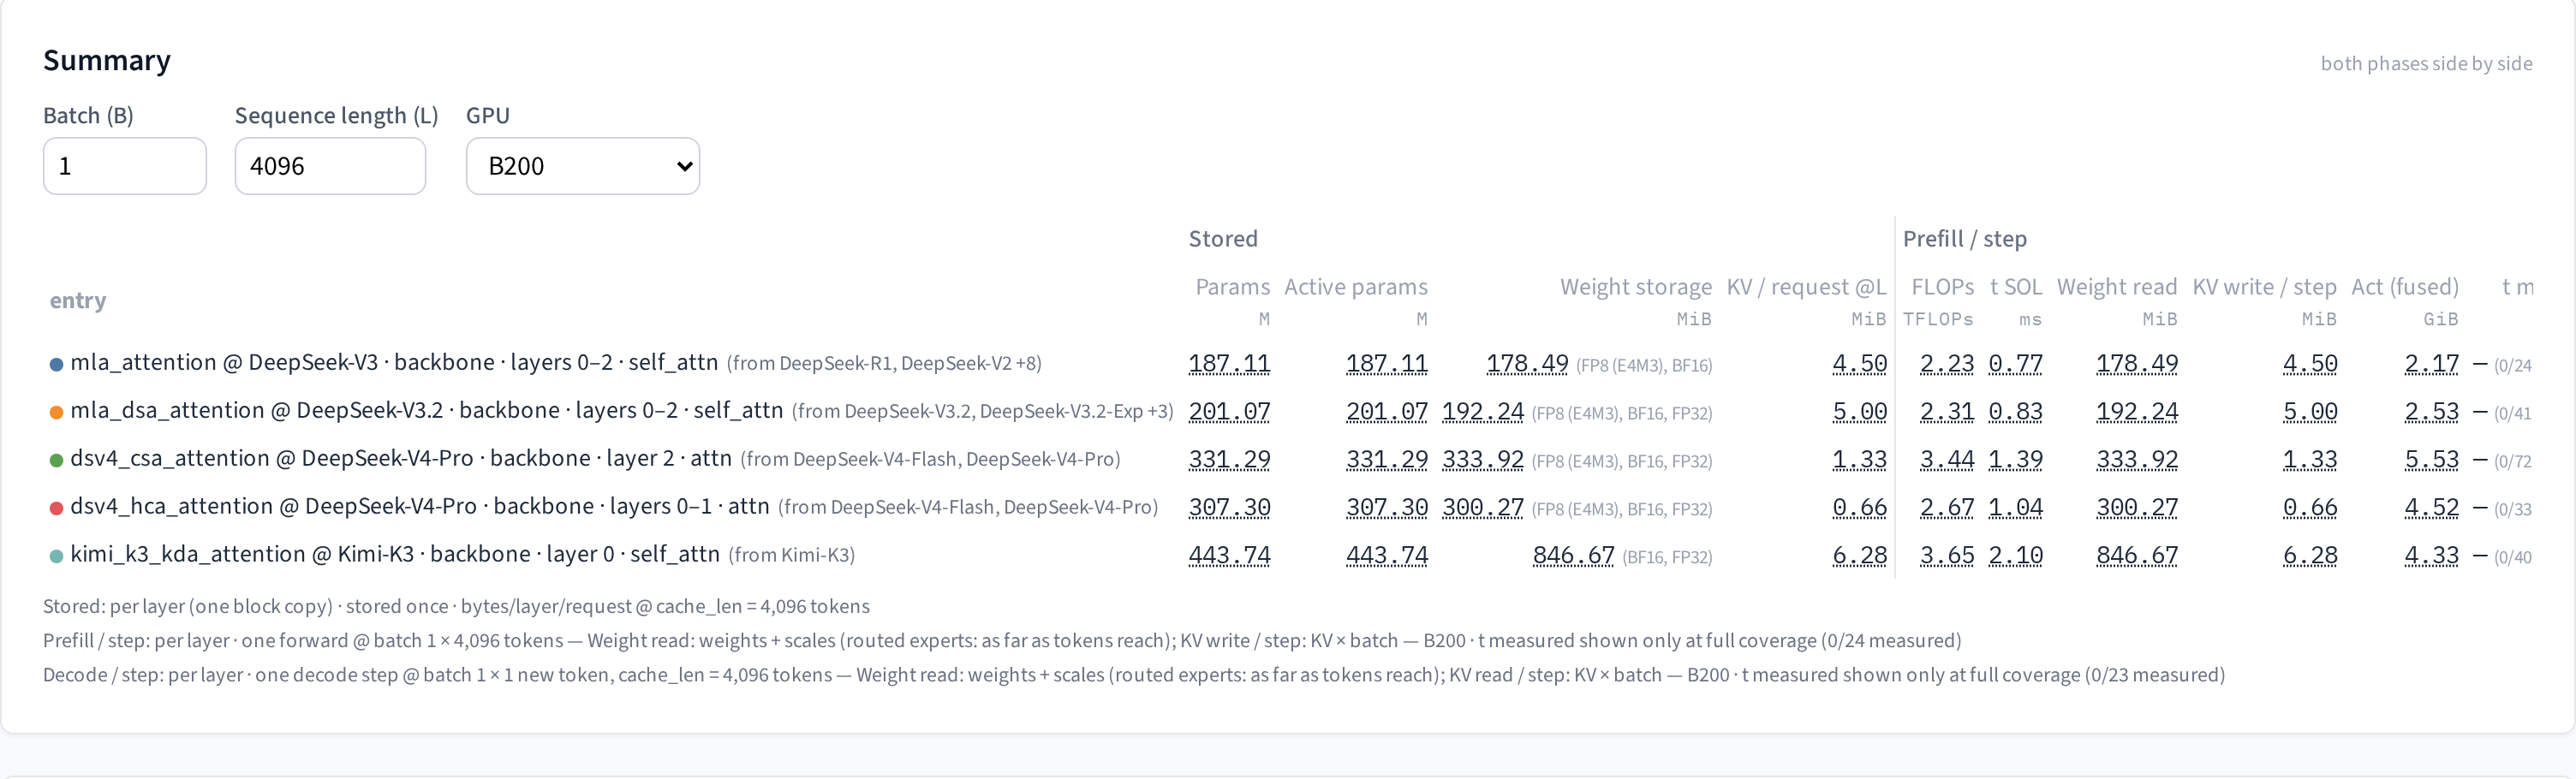
单看每层的参数和 4K 上下文下的 prefill 时间,MLA 最省(每层 1.87 亿参数、0.77 ms),KDA 最重(4.4 亿、2.1 ms)。真正拉开差距的是 KV cache 随上下文的增长:
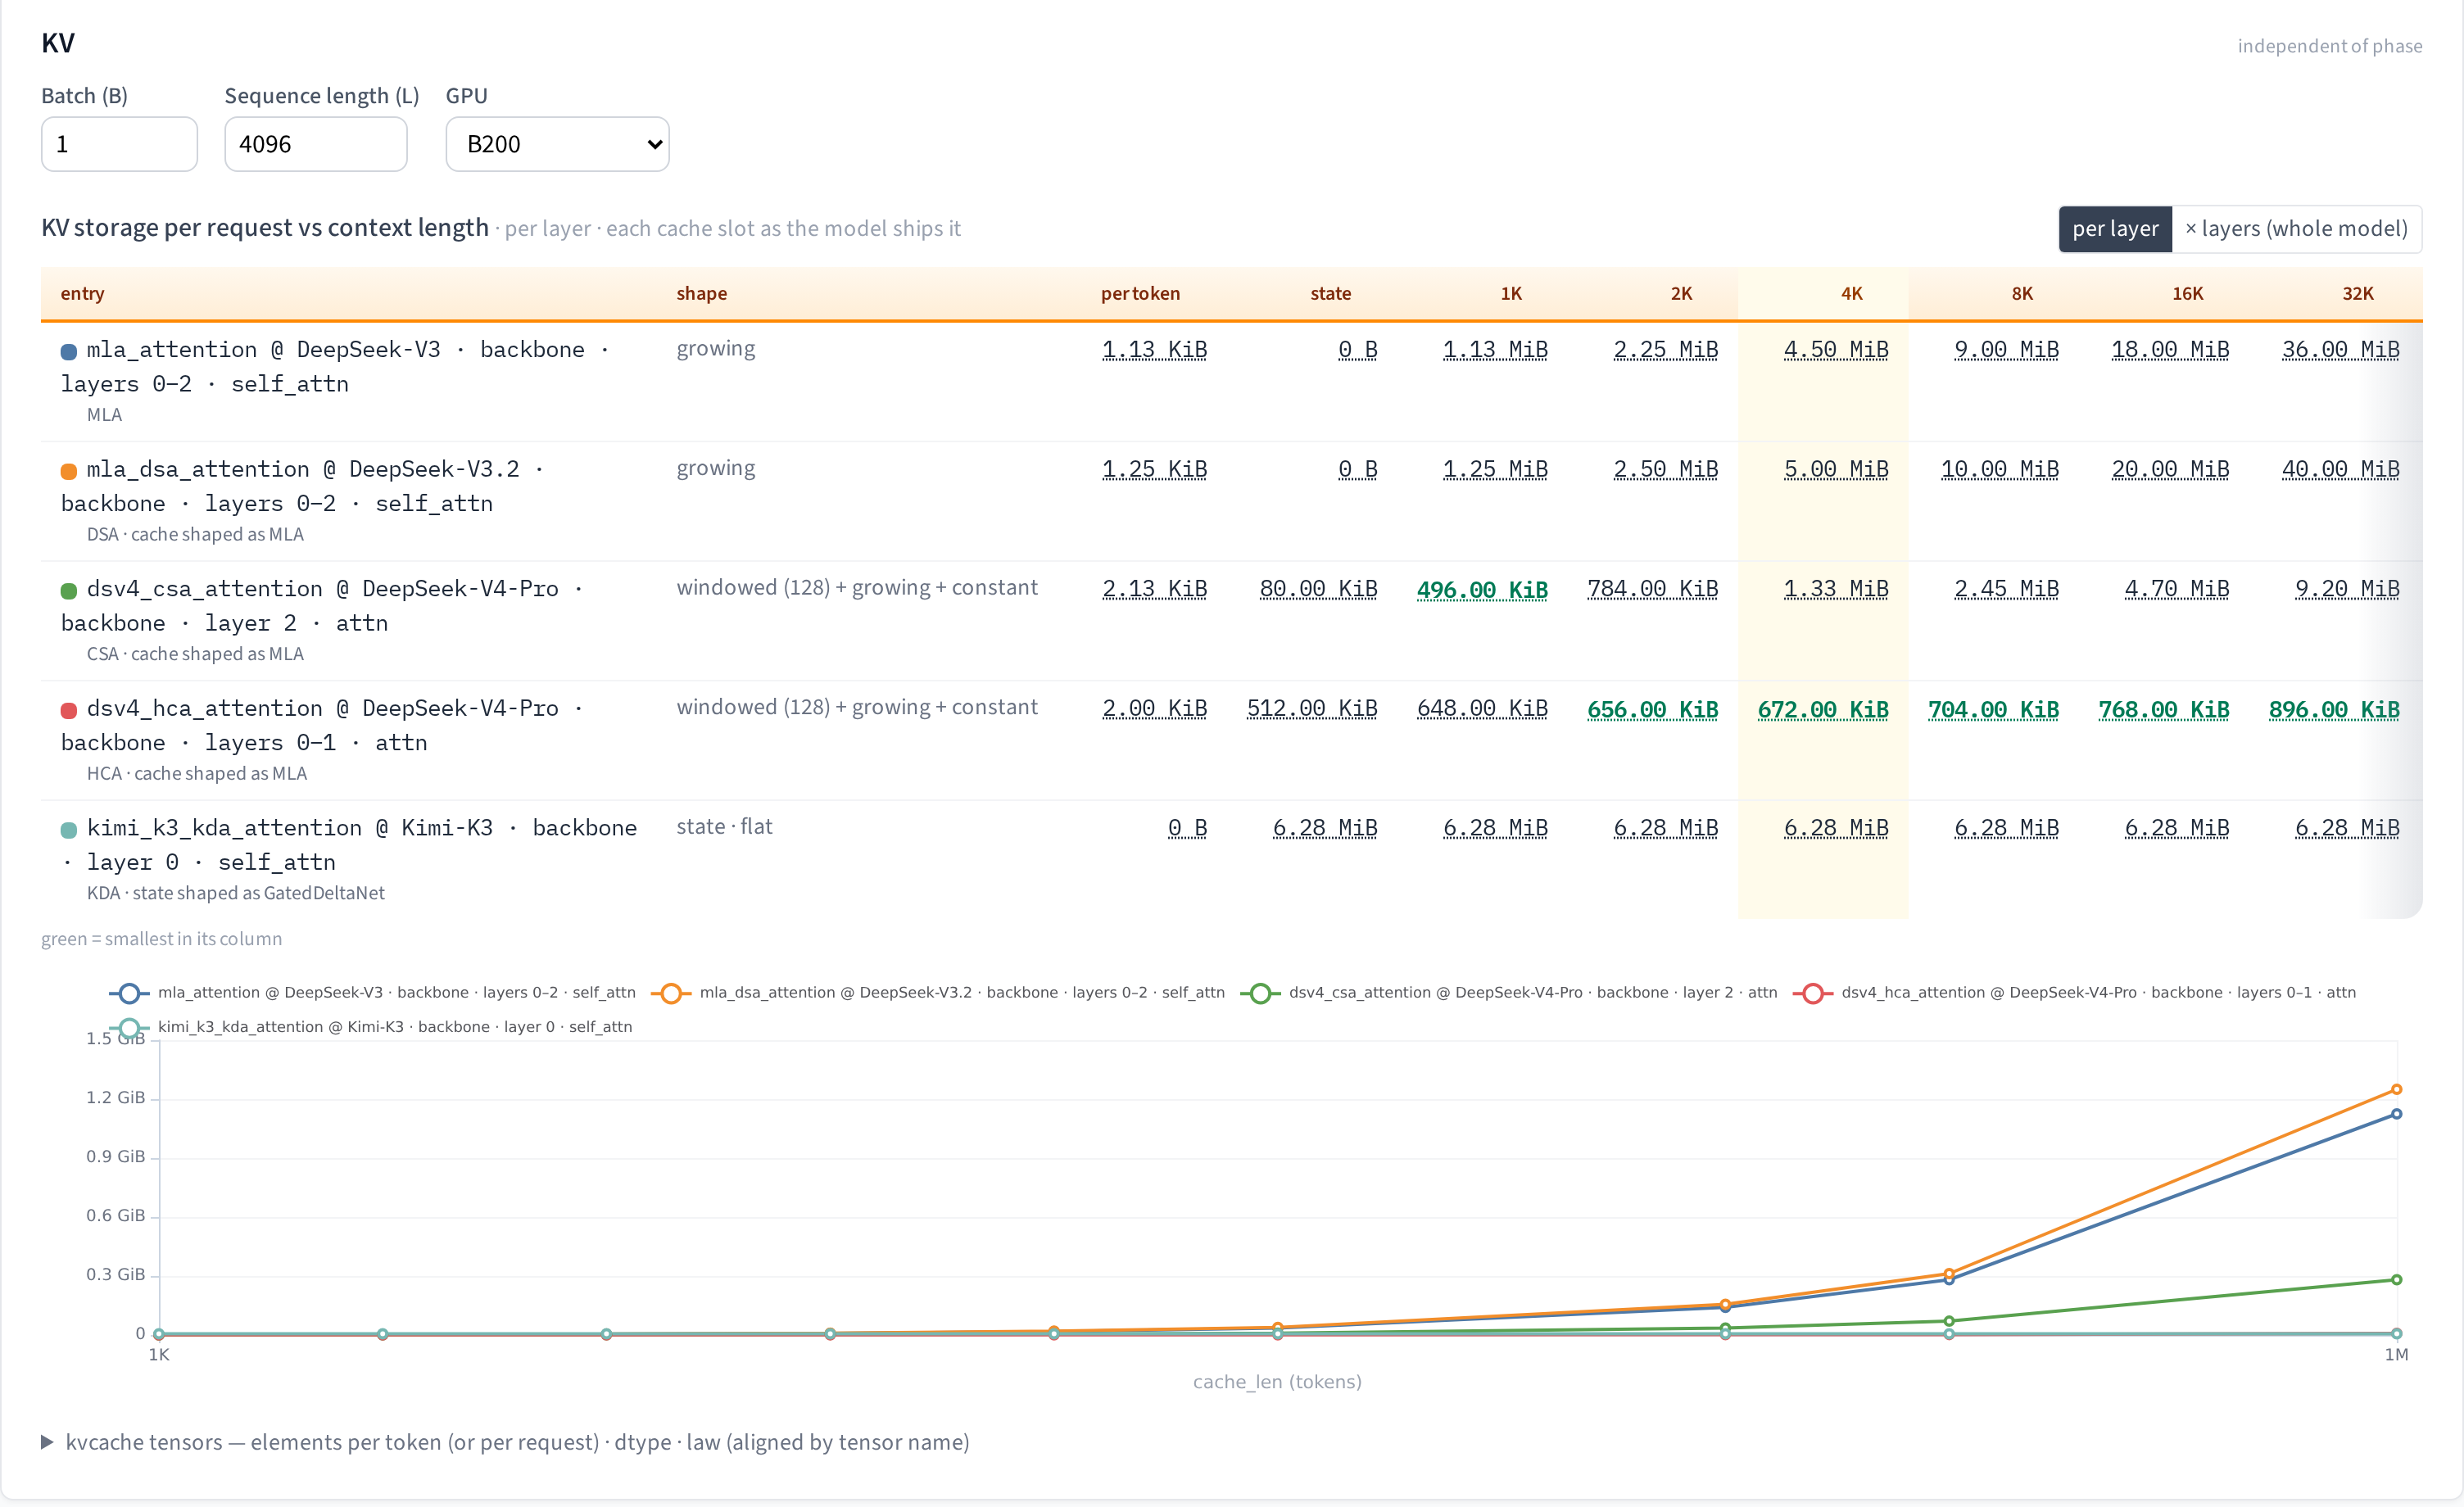
到 32K 上下文,每层每个请求的 KV:MLA 36 MiB,DSA 40 MiB,CSA 9.2 MiB,HCA 0.9 MiB,KDA 始终是 6.28 MiB。这张表把几种设计的取舍摆得很清楚:
- DSA 并不省 KV——它在 MLA 的 latent 之外还多存一份索引键。它省的是计算:一个很轻的索引器先给所有 token 打分,主注意力只看其中 top-k 个,长上下文下注意力的主体开销就不再随上下文平方增长。
- CSA 和 HCA 省的是 KV 本身:都保留一个 128 token 的滑窗,再沿时间方向把更早的 token 压缩存放,HCA 压得更狠,到 32K 还不到 1 MiB。
- KDA 是线性注意力,存的是一个固定大小的循环状态,不随上下文增长。所以它在短上下文反而最"贵"(1K 时 6.28 MiB,MLA 只有 1.13 MiB),过了几千 token 之后就一路领先。
两个模块的结构差在哪,也可以直接对比。下面是 MLA 和 DSA 的计算图 diff:两张图的节点按声明配对,而不是按名字;两边都有但属性不同的节点描成橙色,只有一边有的路径单独标出:
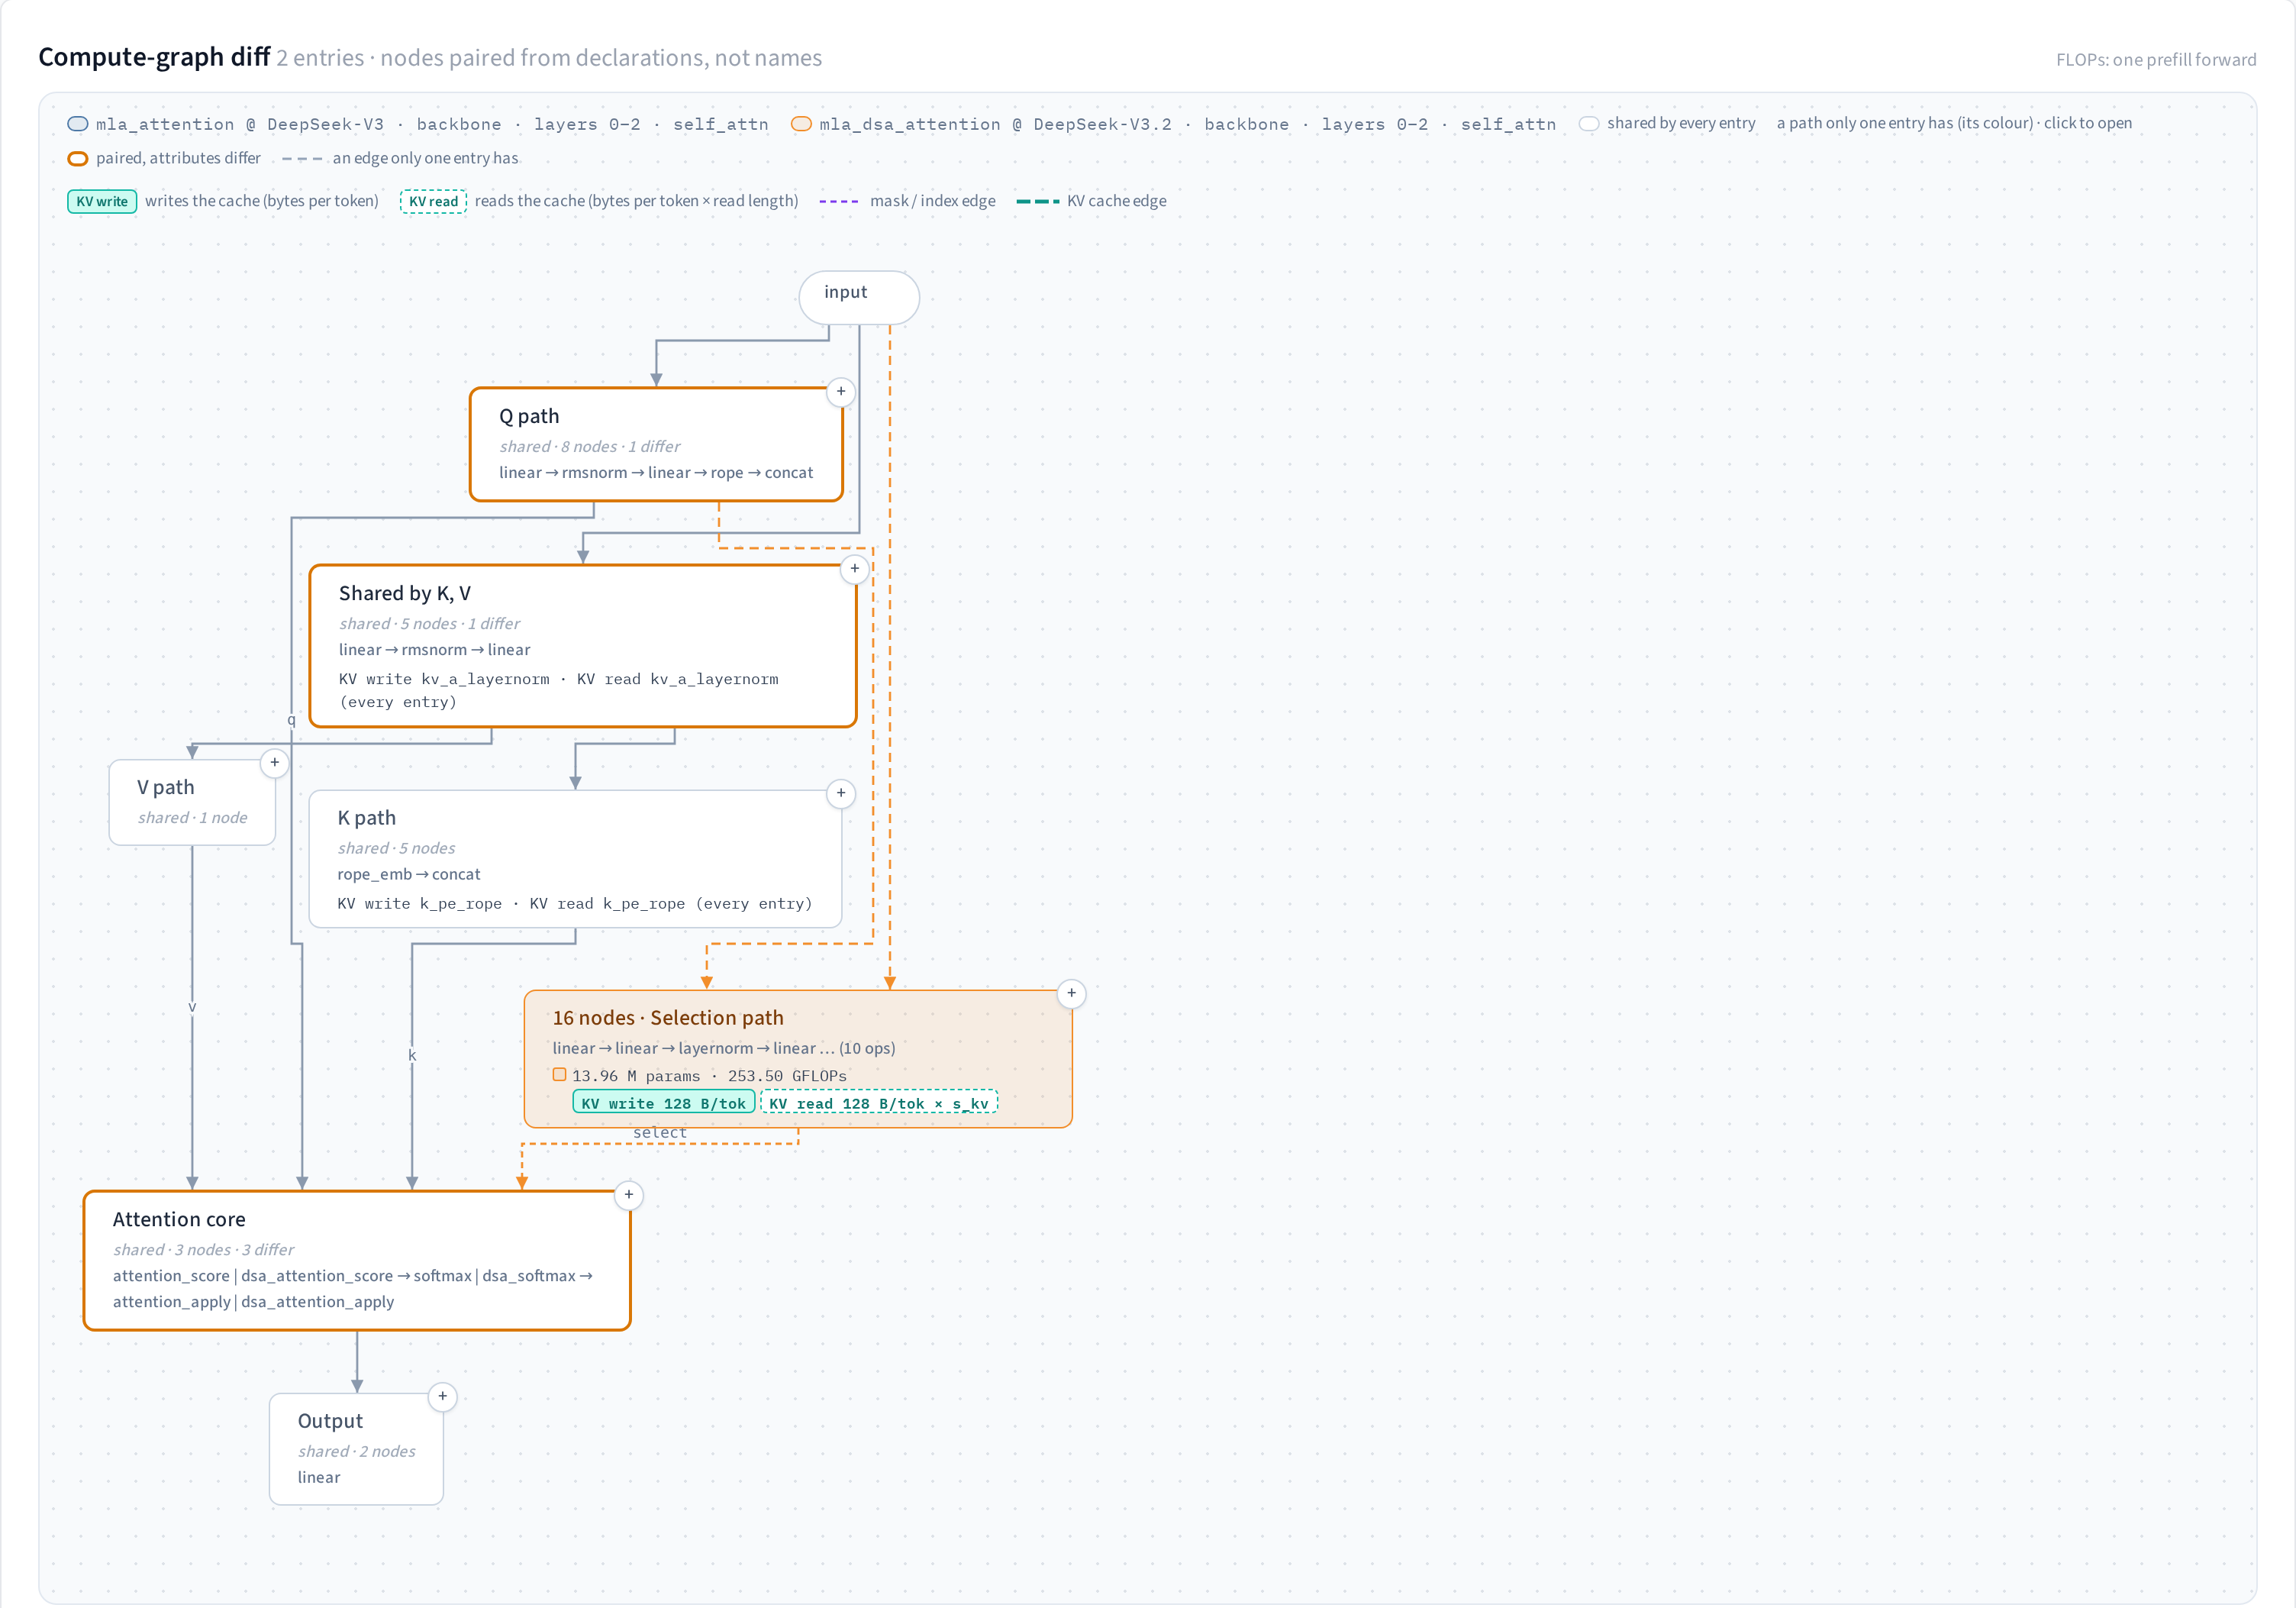
一眼就能看出 DSA 的全部增量:一条 16 个节点的 selection path(也就是 lightning indexer),它自己写一份每 token 128 字节的索引缓存,再通过一条 select 边告诉注意力核心该看哪些 token。
4.2 从已有模型出发:把 V3 的 MLA 换成 DSA
模块对比回答的是单层的代价;想知道换掉之后整个模型怎么样,就用 Model Editor。载入 DeepSeek-V3,它按层分成几组:前 3 层 dense FFN、后 58 层 MoE,外加一个 MTP 头。把前两组的注意力从 mla_attention 换成 mla_dsa_attention——这基本就是 DeepSeek-V3.2 的结构。
换完之后,编辑器不会悄悄补默认值,而是直接指出:DSA 需要三个 MLA 没有的维度(索引头的维度、索引头数、top-k),请你绑定。填上 V3.2 的取值(128、64、2048),整个模型就重新算一遍,每组的参数、FLOPs、权重字节都给出"旧 → 新":
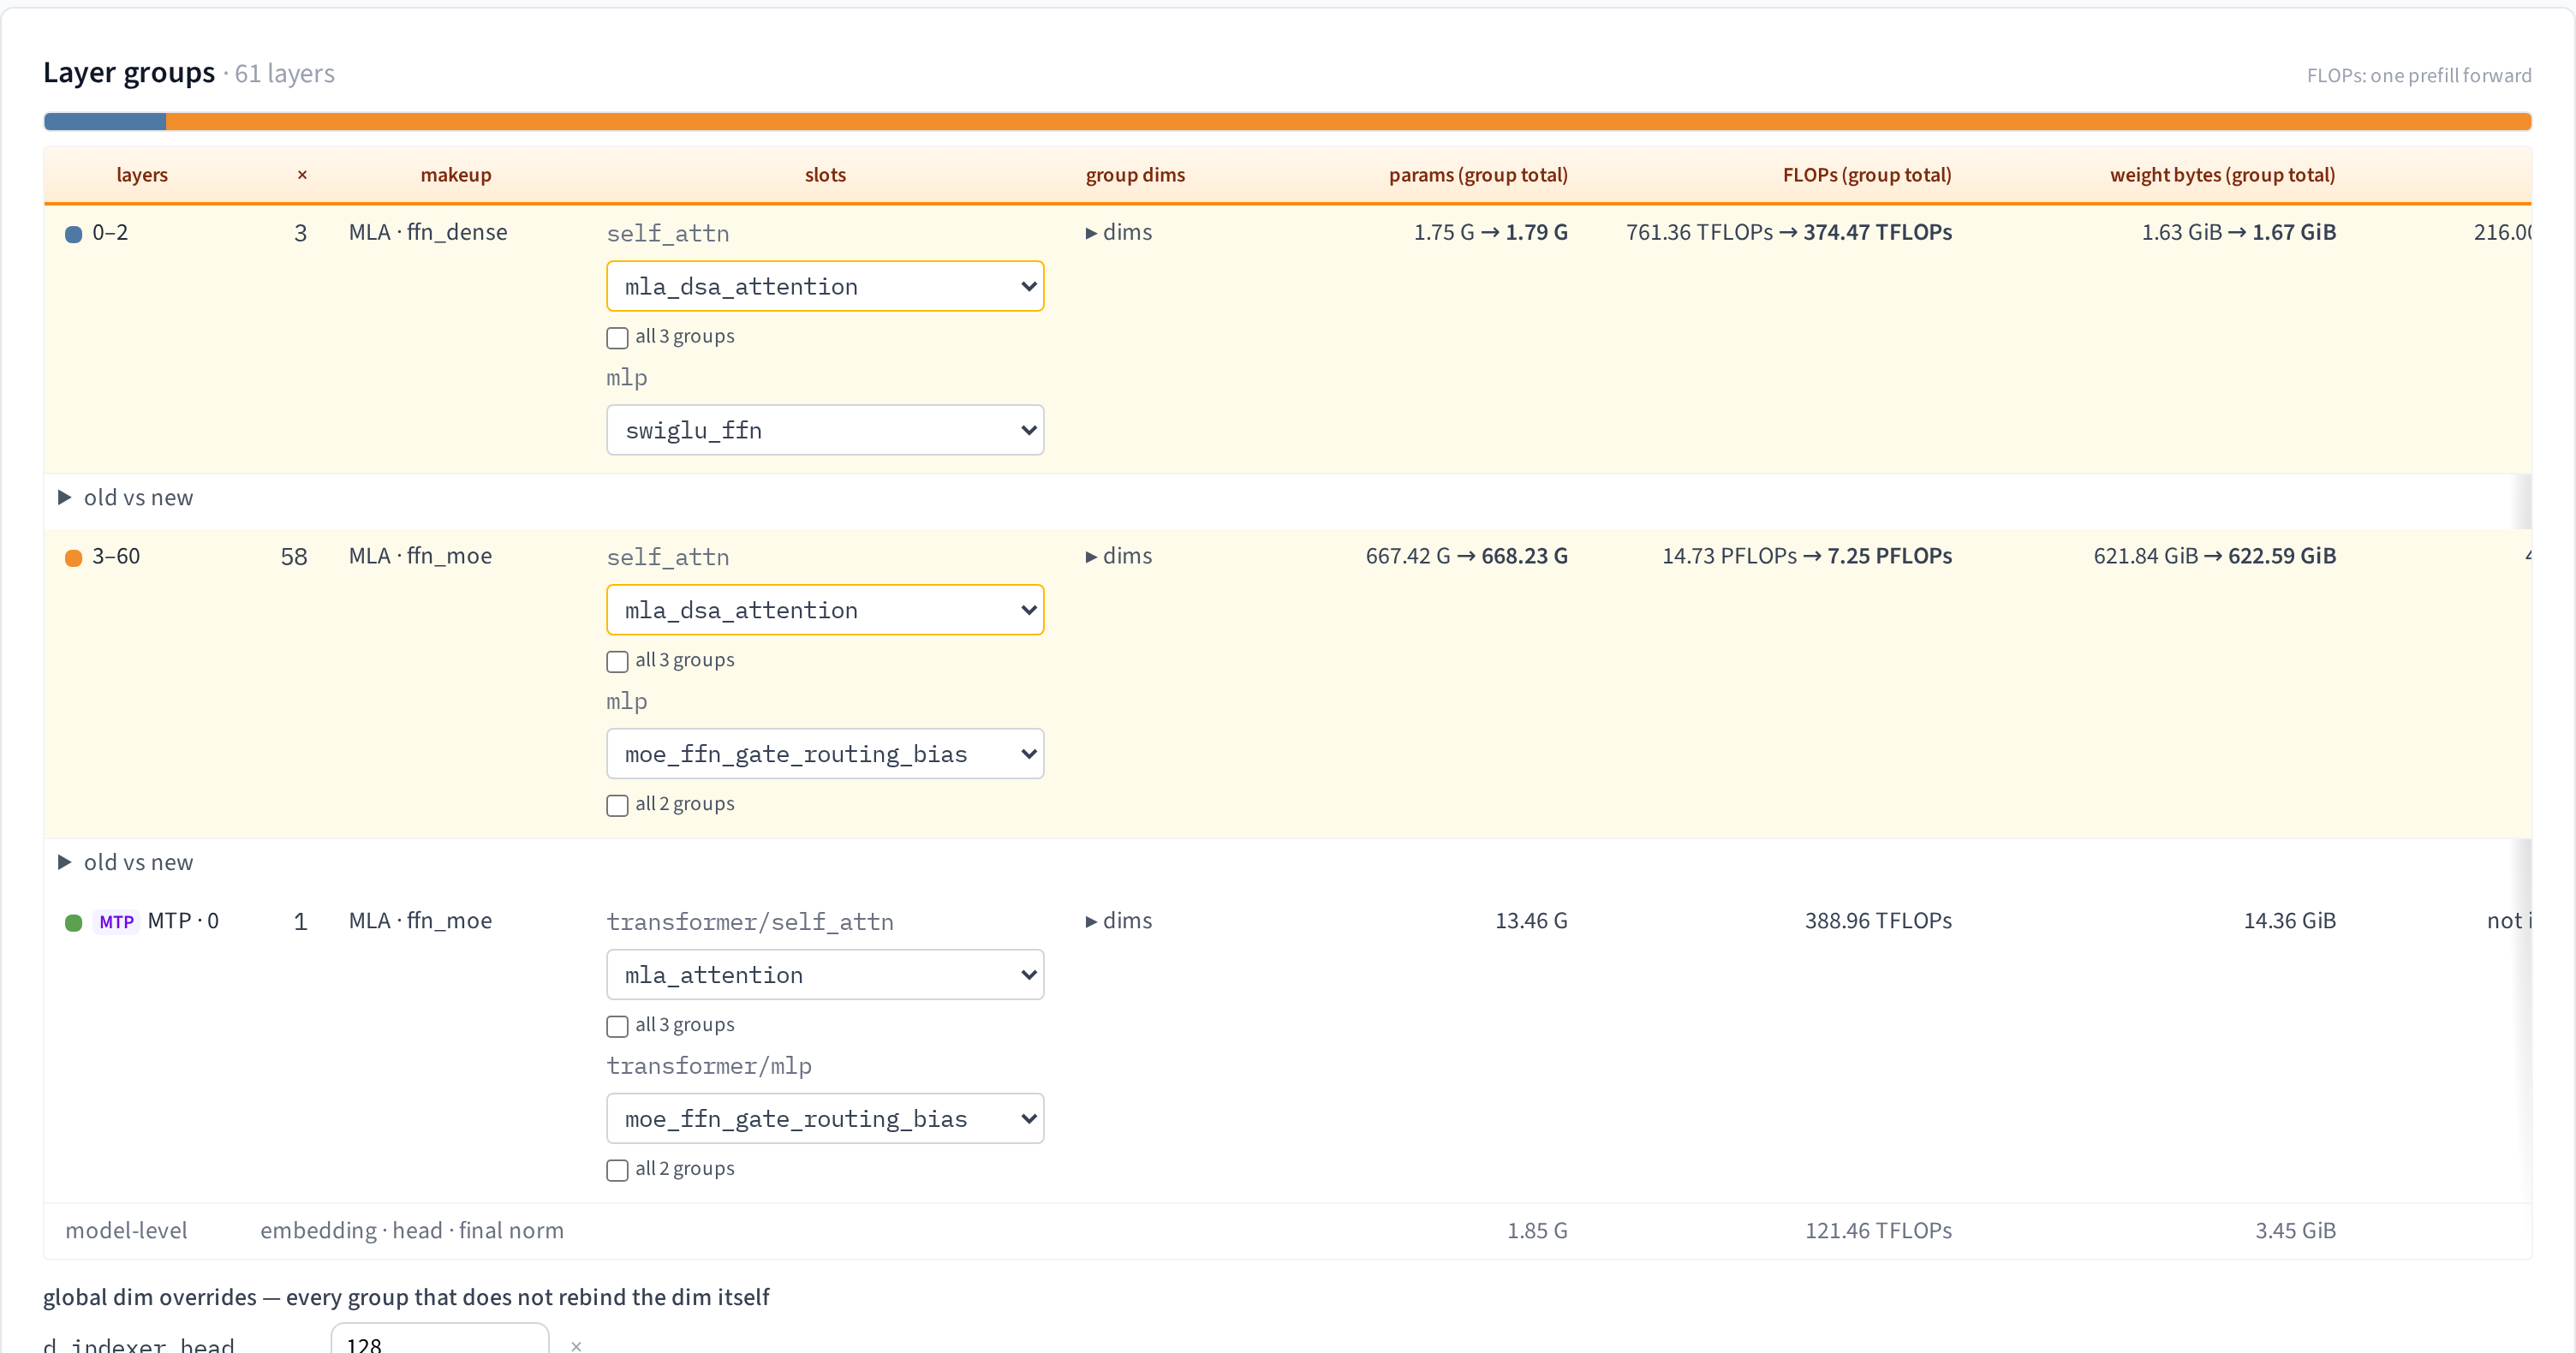
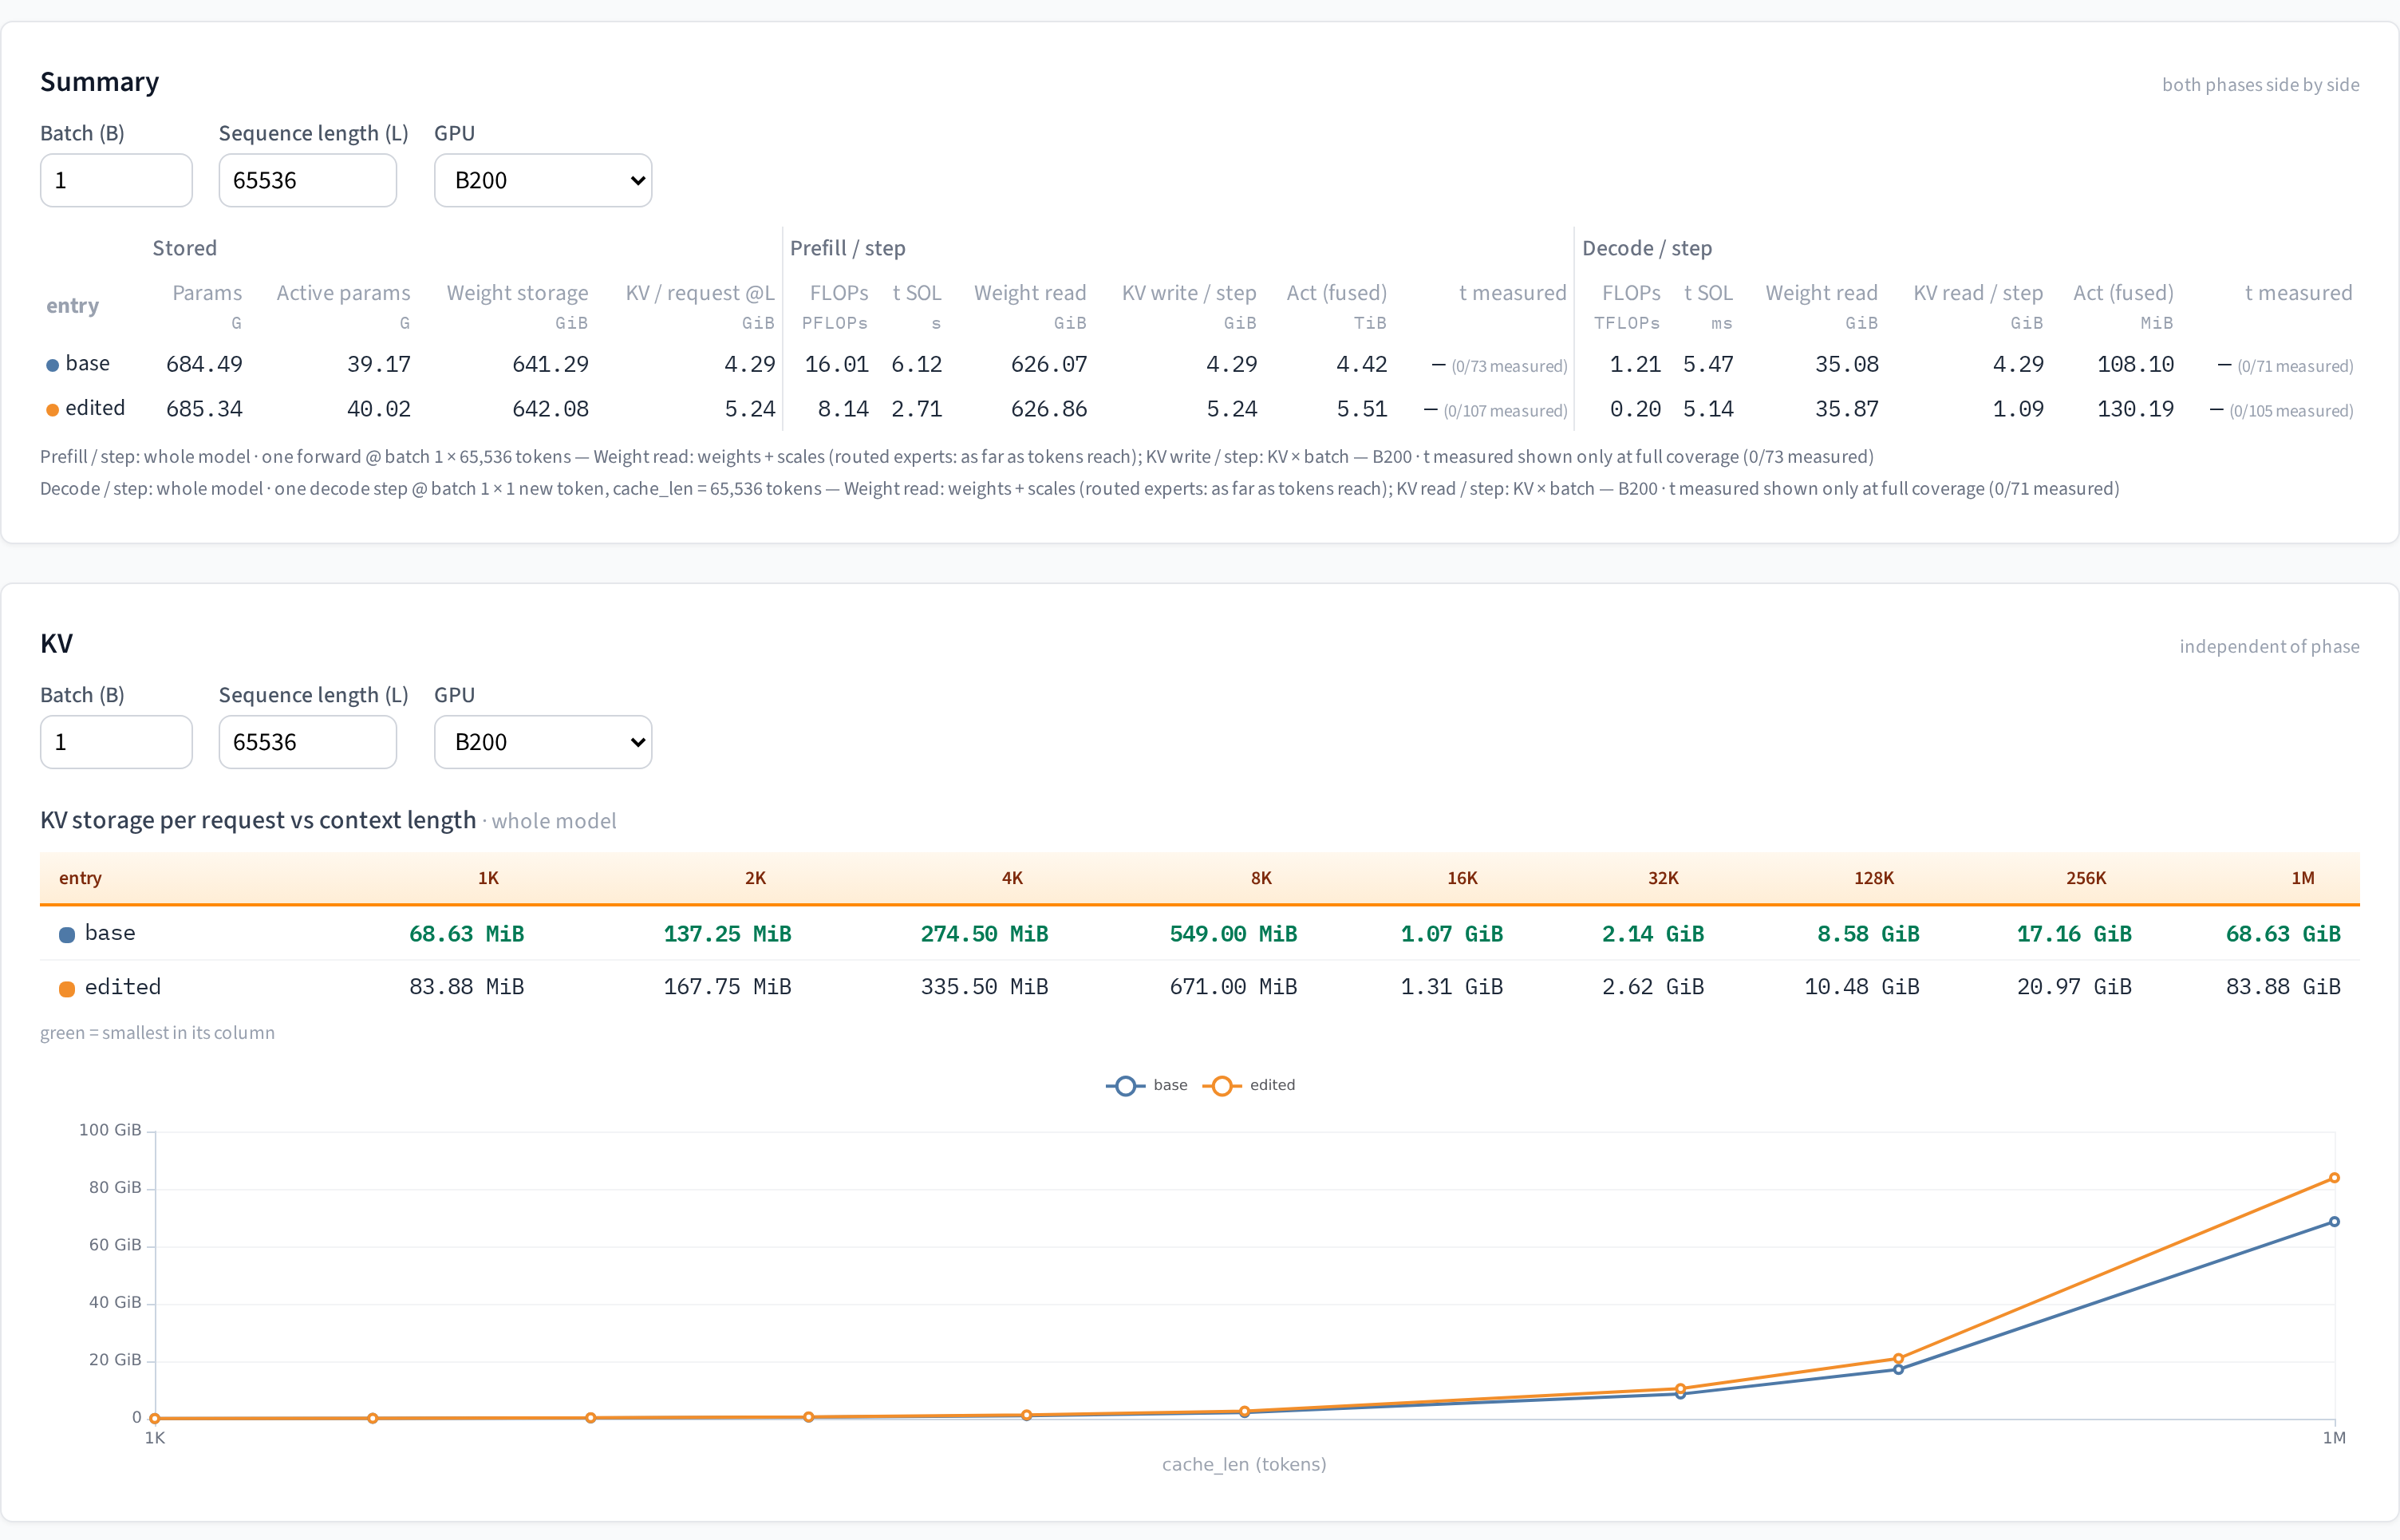
在 64K 上下文、单请求、B200 上:prefill 的 FLOPs 从 16.0 PFLOPs 降到 8.1,SOL 时间从 6.1 秒降到 2.7 秒;decode 每一步要读的 KV 从 4.29 GiB 降到 1.09 GiB。代价是多了约 8.5 亿参数(索引器的权重),以及每个请求多约 22% 的 KV(索引键)。这正是 DeepSeek 从 V3 走到 V3.2 时做的取舍——而在这里,不用写一行代码、不用训练一个模型,几分钟就能把账算出来。
五、一些 Vibe Coding 大项目的心得
HuggingArch 的初版 POC 做得很快,然而缝缝补补一直到国庆长假,才把它拉扯到能见人的程度,其中将近三个月花在了重构上。这里分享几条用 agent 写大项目的心得。
先把架构分层做干净
要做一个维护得动的框架,第一件事是干净的分层。HuggingArch 是一个"算数"的项目,agent 最容易犯的错就是就地打补丁:某个页面的数对不上,就在页面里自己再算一遍;某个模型出了问题,就加一句 if model_id == ...。每个补丁单独看都说得过去,攒多了,不同页面就会对同一件事给出不同的答案——这是这个项目里最常见的 bug:不是逻辑写错了,而是两个地方各算各的。
所以仓库纪律的第一条是:所有数字来自后端的单一来源。 spec 只展开一次、只求值一次,渲染、校验、容量估算、Playground 都只读这一次的结果;缺一个事实,就先在求值里把它算出来、存成字段,再去读,不许下游自己推。第二条是禁止 adhoc 修复:看到 bug 先问它属于哪一类、别处会不会也有,修抽象,而不是修触发它的那一个 case。光写在文档里不够,关键的规矩都要有测试守着:模块之间的依赖方向由一个扫描 import 的测试硬性检查,越界即红;"下游自己推导事实"的地方被逐一数出来做成计分板,只许降、不许升。
CLAUDE.md:所有 agent 共用的仓库规矩
CLAUDE.md 很重要。每个新会话——不管是 Claude、Codex 还是 Kimi——一上来对这个仓库一无所知,CLAUDE.md 是它们共同的入口:项目怎么分层、哪些不变量不能破、加一个算子 / 量化方案 / GPU 型号该改哪里、测试怎么跑。给 Claude.md 足够多的信息、架构原则和代码规范,才能保证你每次会话重启模型都能快速catch up,避免来回低效改动。
双审:一个写,两个审
不管多好的模型,设计一个复杂功能时一定会犯错,而且自己很难发现。我的做法是"三方公审":把改动切成一步一步可以单独评审的小块,每一步由一个 agent 实现,再并行起两个不同的 agent 来评审——一个审实现,逐个分支对比旧行为,并且自己动手实测,而不是只信实现者跑过的测试;一个审设计,看实现是否和事先签过的方案一致,实现中新冒出来的取舍该怎么裁。三方都签字才合进主线;谁不签,实现者修完只让那一方复审。角色不绑定具体模型,Claude、Codex、Kimi、Grok 谁都可以当任何一个角色——不同模型的盲点不同,交叉审正好互补。
这套流程跑顺之后,就可以让它无人值守地一批批往前推:两边都签了就自动合并,只有改了 golden 数据、需要做产品判断这类拿不准的事,才留给人来拍板。
这个 Ralph loop 的左右互搏概念非常实用,最开始重构时,opus 经常边修hack的重构边引入新的hack ———— 古法人工 vibe 怼模型花了几周也毫无进展。用好模型设计 & 写 ———— 次旗舰(国模)进行审,项目能稳中有序地向前推进,大大解决了我重构过程中的难题。
所以作为一个2026年的码农,SOTA token 和便宜 token 都得有!
Roadmap
HuggingArch 仍是一个持续演进的脚手架,接下来几个方向:
- 已有模型的正确性校验/修复:模型太多了,需要花一些时间更细地分析来校验结果的正确性。虽然一些常见模型的数值通过模型观测和人工审核看过是靠谱的,但一只眼睛看不过来,加上新模型在入库,可能在接下来的时间里通过人工分析的方式顺便校验了正确性。
- 更精确的 inference 建模:在已有 speculative-token 与
ep_load_factor参数之上继续扩充调度细节,并以更多通信实测值校准理论 comm 时间,让估算更贴近真实部署。 - 更厚的实测语料:扩展 measured corpus 覆盖的 GPU 型号、算子库与模型——每多一条实测,SOL 上界就多一分收窄到可达吞吐。
- 更完整的 model design 工作流:仓库已经支持导入 custom model;下一步是让架构设计期的编辑、比较与反馈形成更完整的交互闭环。
- 训练成本建模:将成本建模从推理扩展到训练,这个有可能吗(PP bubble也许不行,但memory规划应该很简单)?欢迎找我讨论。
如何 Contribute
这是一个 side-project 性质的开放项目,欢迎 star,也欢迎成为 developer 一起共建。参与方式:
- 贡献模型 spec:为尚未支持的模型运行 agentic 生成流程。缓存发布会重新要求
validate()返回valid: true,其中包括model_storage_bytes.diff == 0;用户随后在账号页跑 Review,PASS 之后自己 Open PR,服务通过 GitHub App 创建 spec bundle PR。在个人资料里填上 GitHub handle,PR commit 会带Co-authored-bytrailer。新 draft component 的 promotion 是另一条 maintainer 流程。 - 贡献实测语料:在自己的 GPU 上运行
kernel_bench并上传 measured CSV。这些数据即时校准你自己的估算(无需公开),也可以 nominate 进共享语料、经 review 后成为所有人可见的公开基线。 - 贡献 component 与 fusion binding:新的拓扑 component 走
components/drafts/→ review →backend.arch.promote;fusion plan / framework binding 则按其 registry 的普通代码 review 流程提交。 - 报告问题、参与讨论:任何一个数值对不上、或某个新架构尚未支持,都欢迎提 issue / PR。【一个人修 bug 不如众筹修bug!】
上手路径与代码结构见仓库的 docs/(README.md 是分层地图),机制细节见各篇 deep-dive。
引用
如果这个项目或这篇文章对你有帮助,可以这样引用:
@misc{shen2026huggingarch,
  author       = {Shen, Han},
  title        = {HuggingArch: Automating Model Architecture Analysis},
  year         = {2026},
  howpublished = {\url{https://shenhan.cc/blog/huggingarch}},
  note         = {Code: \url{https://github.com/shenh10/HuggingArch}}
}
致谢
感谢我的导师徐葳老师提供本项目所用的 H100 与 RTX 4090 GPU,并在机器运维上给予了切实的帮助。没有这些支持,这个项目难以走到今天。